Cosa fa l'IA della società di pagamenti con un trilione di token all'anno?
 Tapbit Wire
Il CTO di Adyen ha dichiarato che l’azienda ha circa 1.400 sviluppatori che consumano circa un trilione di token all’anno. Negli ultimi tre mesi, questo numero è quadruplicato e Adyen si sta preparando per un consumo annuo di cento trilioni di token.
Dove va la spesa in token? Cosa stanno facendo?
I trilione di token di Adyen sono principalmente utilizzati dal team ingegneristico. Analizzando altre società di pagamenti, i token vengono spesi anche per revisioni merchant, risposte al servizio clienti, gestione contestazioni, lettura email e indagini su anomalie.
I soldi scorrono come acqua, e così fanno i token.
Le persone restano sedute immobili, mentre i token continuano a scorrere.
Negli ultimi 90 giorni, l’IA di Adyen ha modificato circa un milione di documenti e partecipato a 20.000 commit Git. La richiesta media di merge è aumentata del 48% e gli ingegneri stimano che l’IA abbia risparmiato loro circa il 15% del tempo. Adyen ritiene che la spesa in token abbia probabilmente generato un ritorno doppio.
Hanno condiviso un esempio: Adyen possiede un sistema backend per i pagamenti, responsabile di fatturazione, riconciliazione e reporting per organizzazioni carte, con circa 2.000 task in produzione riguardanti oltre quaranta organizzazioni carta. Il sistema originale era tutto racchiuso in una singola immagine di deployment; Adyen voleva suddividerlo in modo che ogni organizzazione carta avesse la propria immagine indipendente.
Con le pratiche precedenti, questo progetto avrebbe richiesto più team e 6–12 mesi. Alla fine, due ingegneri, affiancati dall’IA, lo hanno completato in due mesi senza incidenti.
Questo è più o meno come l’Agente di Codifica consuma token. Non si limita a inserire poche righe di codice: legge prima il codice, poi la documentazione, individua le dipendenze ed esegue i test. Se questi falliscono, legge i messaggi di errore, modifica il codice ed esegue nuovamente i test. Quando una persona apre più agenti contemporaneamente, questi processi si ripetono in background. Le persone restano sedute immobili, mentre i token continuano a scorrere.
Anche Stripe ha riferito che il 91% dei suoi ingegneri usa l’IA quotidianamente (non è chiaro perché il restante 9% non sia stato licenziato). L’agente interno di codifica invia oltre 1.000 PR all’ambiente produttivo ogni settimana. Solo a marzo 2026, Stripe ha registrato oltre 57.000 PR che hanno utilizzato l’assistenza AI per la codifica, con un aumento del 140% in tre mesi.
Block è simile: circa 7.500 dipendenti usano l’IA settimanalmente e oltre il 90% delle submission di codice coinvolge l’IA, con un aumento medio del 30% delle modifiche settimanali al codice.
Attualmente sembra che una parte consistente della bolletta token delle società di pagamenti provenga dal dipartimento ingegneristico. L’uso dell’IA nel settore pagamenti non riguarda solo la scrittura ex novo di codice, ma soprattutto aiutare gli umani ad affrontare la montagna della complessità. I sistemi di pagamento sono vasti, pieni di codice legacy e devono supportare banche, organizzazioni carta e vari metodi di pagamento. In passato questa complessità assorbiva soprattutto il tempo degli ingegneri; oggi vi si aggiunge l’IA, che consuma token.
Ricerca documenti, stesura annunci, lettura contratti: tutto consuma token.
Scrivere codice è solo una parte dell’uso interno dell’IA. Una fintech leggermente più grande dedica molto tempo ogni giorno alla ricerca di informazioni: dov’è la policy sui rimborsi? Quale team gestisce questi dati? Dove richiedere i permessi per un certo sistema? A chi rivolgersi per chiedere ferie? Più grande è l’azienda, più documenti ci sono; più documenti ci sono, più facile è perdersi.
Nubank conta circa 9.000 dipendenti e i diversi team pubblicano processi e documenti su Confluence. Quando i dipendenti incontrano problemi, potrebbero dover cercare per mezz’ora; se non trovano nulla, aprono un ticket e attendono ore. Nubank ha quindi creato uno strumento interno chiamato AskNu, che permette ai dipendenti di porre domande direttamente su Slack. AskNu identifica prima il dipartimento competente, cerca la risposta nei documenti Confluence corrispondenti, quindi organizza una risposta tramite un modello linguistico avanzato, includendo il link originale.
Sei mesi dopo il lancio, AskNu aveva 5.000 utenti e gestiva 280.000 messaggi. Nubank ha dichiarato di aver ridotto alcuni ticket interni del 96%. Problemi che prima richiedevano 30 minuti per essere risolti o un’attesa di 8 ore per un ticket ora ricevono risposte in media in 9 secondi.
AskNu non aiuta direttamente i clienti a trasferire denaro o elaborare pagamenti, ma legge continuamente le domande, recupera documenti e organizza le risposte. Ogni persona in azienda pone alcune domande al giorno e i token si accumulano gradualmente.
Anche il team dei contenuti è lo stesso. Chime ha chiamato il proprio modello interno di contenuti in modo molto diretto: ChimeGPT. Ha inoltre creato un «cervello del brand» che include storie passate sul brand, feedback degli utenti, risultati delle campagne e discussioni della community. Il team marketing lo utilizza per generare diverse versioni di contenuti e processi di onboarding personalizzati, sottoposti poi a revisione da parte del brand, legale e compliance.
Chime ha rivelato che la produzione interna di contenuti è aumentata di oltre il 300% su base annua e i tempi di produzione sono diminuiti del 60%. Ciò che prima richiedeva dieci ore, dalla concezione alla campagna, ora può essere completato in circa quattro ore, con un triplicarsi del volume di test. Anche i dati organizzativi di Klarna sono interessanti: il 90% dei dipendenti utilizza quotidianamente l’IA generativa, con tassi d’uso nei team comunicazione, marketing e legale pari rispettivamente al 93%, 88% e 86%.
Scrivere codice consuma token, così come scrivere annunci pubblicitari, tradurre materiali, riassumere riunioni, leggere contratti e rispondere alle domande dei colleghi.
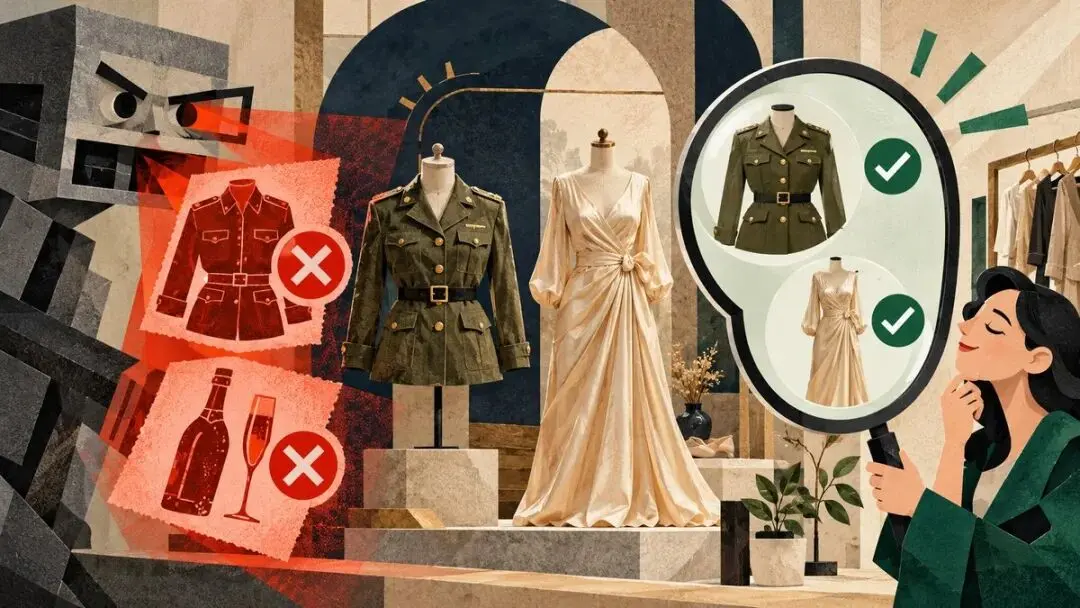
«Vestito color champagne» non significa vendita di alcolici.
Le società di pagamento svolgono quotidianamente un compito simile alla verifica dell’identità: chi è questa persona? Che cosa sta esattamente vendendo? Possiamo permetterle di entrare e riscuotere denaro?
I commercianti certamente non si presentano onestamente secondo i moduli della società di pagamenti. Gli indizi sono sparsi su siti ufficiali, pagine prodotto, documenti di registrazione e articoli di notizie, e possono essere scritti in lingue diverse. I sistemi precedenti non avevano la pazienza necessaria per affrontare tale complessità, e il metodo più semplice era controllare le parole chiave.
Airwallex ha fornito un esempio ironico. Un commerciante vende una «giacca in stile militare», e il sistema rileva «militare», il che potrebbe farlo sospettare di vendita di beni militari vietati; un altro commerciante scrive «vestito color champagne», e il sistema vede «champagne», il che potrebbe portarlo a pensare che venda alcolici.
Una persona capisce al volo che una giacca in stile militare non è un’arma e che in un vestito color champagne non c’è champagne. Ma le parole chiave non comprendono né colori né moda: sanno solo che quella parola sembra un po’ pericolosa.
È proprio questo il punto di forza dei grandi modelli: non concentrarsi su una singola parola, ma leggere prima il contesto circostante e capire cosa il commerciante sta effettivamente vendendo. Airwallex ha dichiarato che, dopo aver integrato l’IA generativa nella procedura KYC, il tasso medio di falsi positivi nei processi correlati è diminuito del 50% e il numero di clienti in grado di completare l’onboarding senza intervento umano è aumentato del 20%.
Anche Stripe ha iniziato a usare modelli linguistici (LLM) per l’onboarding dei commercianti nel 2023. Non permette al grande modello di approvare tutti i commercianti, ma prima elabora informazioni aperte e non strutturate, accelerando l’elaborazione delle richieste chiaramente conformi. Oltre l’80% dei «commercianti idonei» può essere approvato automaticamente in tempo reale. La revisione delle policy da parte di Checkout.com è passata da 60 a 10 minuti.
Prima, i dipendenti dovevano aprire pagine web, leggere i materiali, verificare le policy e redigere autonomamente le conclusioni; ora il grande modello legge prima e evidenzia le aree che richiedono attenzione umana. I token consumati qui si traducono in meno falsi positivi, aperture conto più veloci e minor tempo impiegato dal personale interno su materiali privi di problemi.
Anche una tazza di caffè da cinque dollari deve passare attraverso la funzione finanziaria.
Le società di pagamento aiutano altri a gestire il denaro, ma internamente devono comunque effettuare rimborsi, audit sulle spese, solleciti fatture e attività contabili. Questo potrebbe essere il tipo più discreto di prodotto fintech basato sull’IA. Quando un dipendente usa la carta aziendale per acquistare una tazza di caffè, potrebbe dover caricare lo scontrino, specificarne la finalità e selezionare una categoria di spesa; i manager devono confermare se si tratta di una spesa lavorativa, la funzione finanziaria deve verificare la policy, effettuare la contabilizzazione e sincronizzare il tutto nell’ERP. L’importo potrebbe essere solo di cinque dollari, ma il costo del lavoro per elaborarlo è spesso superiore.
Ramp ha creato un Policy Agent appositamente per verificare questo tipo di spese. Controlla se lo scontrino corrisponde alla transazione, se ci sono rimborsi duplicati, se la finalità è chiaramente indicata, se viola la policy aziendale e se il dipendente ha avuto recentemente spese insolite. Le spese conformi possono essere suggerite automaticamente per l’approvazione, mentre quelle problematiche vengono assegnate a un operatore umano. Ramp afferma che i primi clienti hanno ridotto le revisioni manuali di circa l’85%, raggiungendo un tasso di accuratezza superiore al 99% nell’applicazione delle policy sulle spese, mentre l’autorità finale di approvazione rimane comunque all’addetto alla revisione.
Brex Assistant gestisce compiti ancora più banali. Trova automaticamente gli scontrini, redige note, compila categorie di spesa e partecipanti e interroga proattivamente i dipendenti sulle spese non conformi. Brex ha fornito un esempio: uno scontrino potrebbe non riportare «alcolici», ma solo «vodka». Le regole basate su parole chiave potrebbero non coglierlo, ma il grande modello sa che la vodka rientra negli alcolici.
Questo tipo di lavoro è particolarmente adatto a scambiare token con tempo.
Gli analisti AML trascorrono la maggior parte del tempo non a individuare i colpevoli.
Le società di pagamenti generano quotidianamente un gran numero di allarmi di rischio. Potrebbero esserci poche transazioni effettivamente sospette, ma ogni allarme richiede che qualcuno lo apra, verifichi i dati del cliente, esamini le transazioni storiche, controlli i conti correlati e rediga un paragrafo che spieghi perché chiuderlo o approfondirlo. Molti analisti AML non passano il tempo a individuare i colpevoli, bensì a dimostrare che una persona non appare attualmente sospetta.
Nexo utilizza l’Agente AI di Unit21 per la revisione preliminare degli allarmi. L’agente organizza informazioni su transazioni e conti, analizza le relazioni tra indirizzi e genera riassunti investigativi e pareri operativi. Gli analisti non partono più da zero, ma verificano i materiali e le conclusioni forniti dall’IA.
Nel case study pubblicato congiuntamente da Unit21 e Nexo si evidenzia che il tasso di falsi positivi di Nexo è diminuito del 93% rispetto al precedente sistema interno; attualmente il 57% delle revisioni di allarmi è completato automaticamente dall’IA, con l’obiettivo di raggiungere l’80%. Questi dati vanno considerati con attenzione: provengono da una pubblicazione congiunta fornitore-cliente, non da un audit indipendente; Unit21 non ha rivelato quanti token vengono consumati per ogni indagine.
Tuttavia, questo caso illustra chiaramente cosa può fare l’IA nell’ambito AML: la macchina raccoglie i dati, mappa le relazioni e redige la narrazione; gli esseri umani valutano poi se il caso è effettivamente sospetto e se segnalarlo alle autorità.
Un cliente ha semplicemente chiesto: «Dov’è il mio denaro?»
Il servizio clienti nelle società di pagamenti non è sempre semplice come «aiutatemi a cambiare la password». Quando un cliente chiede «perché il denaro non è ancora arrivato?», potrebbe entrare in gioco la banca acquisente, l’organizzazione della carta, la banca emittente, la conversione valutaria, il ciclo di regolamento, lo stato del rimborso o restrizioni sul conto. Gli operatori devono consultare più sistemi e ricomporre le informazioni per fornire una risposta coerente.
Gli Agenti IA seguono lo stesso processo: prima comprendono il problema, poi interrogano la transazione, recuperano le regole, determinano il passo successivo e infine generano una risposta. Ogni volta che un sistema viene interrogato, i risultati devono essere restituiti al modello e i token vengono consumati ripetutamente.
Checkout.com afferma che circa il 60% delle richieste di assistenza sono domande semplici e ripetitive; entro il 2026, prevede che gli Agenti IA gestiranno autonomamente oltre la metà del volume complessivo. Block ha rivelato che circa il 65% dei casi di assistenza di Cash App utilizza già l’IA. I dati di Klarna sono ancora più diretti: il suo Assistente IA ha servito oltre 4 milioni di clienti nel primo semestre 2024, con un risparmio annuo previsto di 40 milioni di dollari.
Il calcolo dei token usati per l’assistenza clienti è diretto: prima un certo numero di persone gestiva un certo numero di ticket; ora un certo numero di token gestisce lo stesso numero di ticket, e si può contare se ci sia stato un passaggio all’operatore umano o se il cliente abbia riaperto il caso.
Anche gestione contestazioni e chargeback funzionano così. Stripe riceve numerose email automatizzate dai partner finanziari, che prima richiedevano lettura manuale e successiva elaborazione nel sistema; ora i modelli linguistici (LLM) leggono prima le email, ne comprendono la richiesta e trasformano le istanze in chiamate API. Checkout.com ha inoltre dichiarato che la distribuzione delle transazioni rifiutate, prima eseguita manualmente, è ora completamente automatizzata.
Questi compiti potrebbero non sembrare altrettanto epocali quanto «l’IA che rivoluziona la finanza», ma sono molto dispendiosi in termini di tempo e ideali per il consumo di token.
Quando l’IA comincia a parlare osservando il tuo portafoglio
Gli IA menzionati finora sono per lo più invisibili ai clienti: operano in background, nei codici, negli audit e nei sistemi di assistenza. Robinhood Cortex è diverso: appare direttamente sui dispositivi mobili degli investitori.
Quando un utente apre un titolo, Cortex legge quotazioni in tempo reale, notizie urgenti, report di analisti, indicatori tecnici e dati interni di Robinhood, poi spiega in termini semplici perché il titolo sta salendo o scendendo quel giorno. Inoltre, integra queste informazioni con il portafoglio dell’utente per chiarire perché tale notizia è rilevante per il suo conto.
Robinhood ha rivelato che, entro il primo trimestre 2026, quasi 1 milione di clienti aveva già utilizzato i Digests di Cortex. Il prossimo passo è consentire agli utenti di acquistare e vendere azioni e criptovalute, analizzare i mercati e modificare le impostazioni del conto direttamente tramite linguaggio naturale.
A questo punto non sono più solo i dipendenti aziendali a consumare token: ogni volta che un utente pone una domanda, Cortex legge una notizia o un report di ricerca, e ogni volta che rielabora il contenuto in base al portafoglio personale, deve processare nuovamente il contesto.
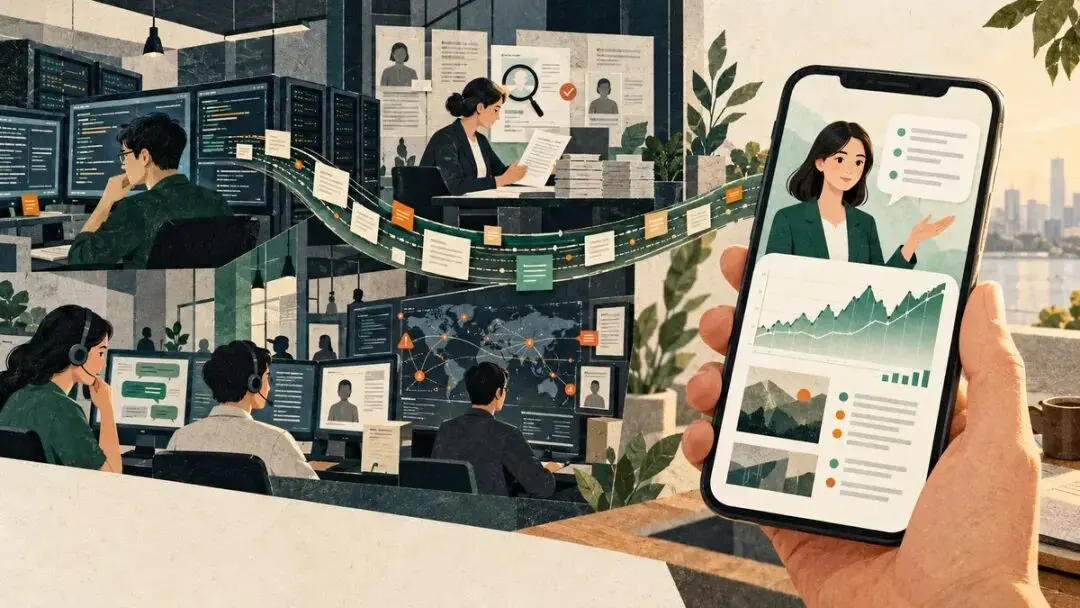
Il vero problema è che, una volta che l’IA agisce per conto degli utenti, il costo degli errori cambia. Se una notizia è riportata male, l’utente potrebbe semplicemente essere fuorviato; se invece un’azione su un titolo è eseguita erroneamente, si perdono soldi veri. Per questo Robinhood ha fissato limiti precisi per Cortex: quali dati può vedere, cosa può dire e quali azioni richiedono conferma esplicita dell’utente.
Un trilione di token: cosa significa per le aziende di intelligenza artificiale?
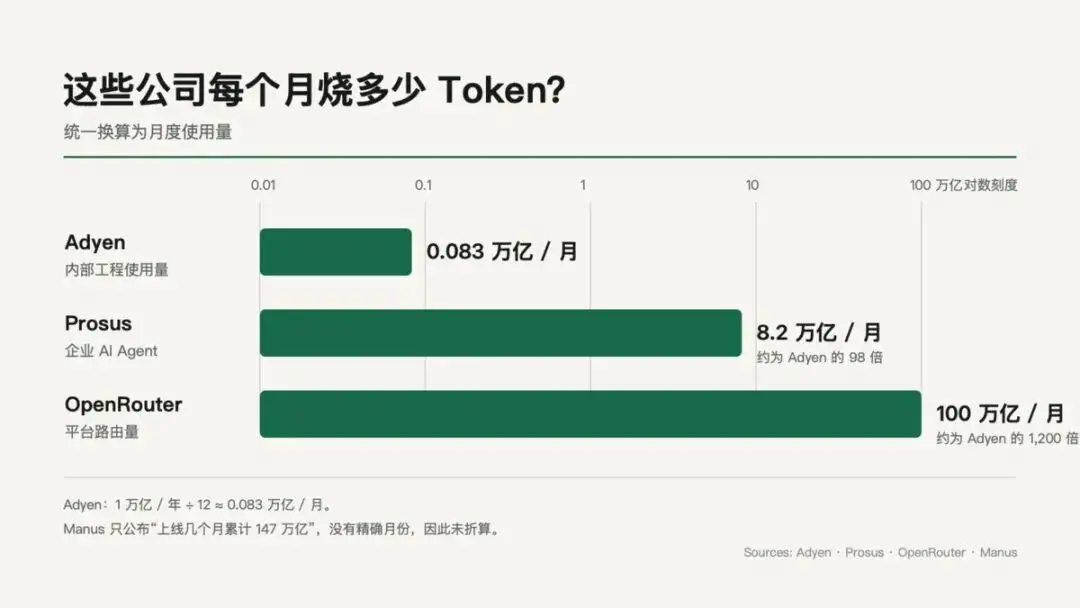
Innanzitutto, osserviamo Adyen stessa: circa 1.400 sviluppatori utilizzano 1 trilione di token all’anno, in media 710 milioni a testa. Supponendo 250 giorni lavorativi, ciò equivale a circa 2,86 milioni di token a persona al giorno. Non si tratta più solo di far completare occasionalmente poche righe di codice all’IA, ma di avere un agente che lavora tutto il giorno.
Ma quando questo numero viene contestualizzato nel settore dell’IA, l’unità di misura cambia rapidamente.
Il prodotto di Manus è online da alcuni mesi e ha già elaborato oltre 147 trilioni di token, equivalente all’uso di Adyen per 147 anni. OpenRouter ora instrada 100 trilioni di token al mese, pari all’uso annuale di 100 aziende come Adyen ogni mese. Ovviamente si tratta di piattaforme che servono un gran numero di clienti e non sono direttamente confrontabili con un team ingegneristico interno di una singola azienda, ma l’ordine di grandezza della differenza è intuitivamente chiaro.
Considerando un’azienda più simile a un’impresa tipica, Prosus gestisce numerose operazioni di e-commerce e internet, con agenti IA che servono 40.000 dipendenti, 5 milioni di partner e 1 miliardo di utenti. Consuma 82 trilioni di token al mese, completando l’intero quantitativo annuale di Adyen ogni quattro giorni. Nell’ultimo anno, il suo consumo di token è cresciuto di 52 volte.
OpenAI non ha rivelato quanti token consuma annualmente, ma ha indicato quanto possono spendere i ricercatori. Entro agosto 2026, il costo computazionale giornaliero mediano per un ricercatore, basato sui prezzi API, supererà i 600 dollari. Il 10% più alto potrà spendere oltre 7.000 dollari al giorno. Supponendo 250 giorni lavorativi all’anno, una persona spenderà 150.000 dollari, mentre gli utenti più intensivi raggiungeranno 1,75 milioni.
Anthropic è più diretta: misura non i costi, ma le ore lavorative. Entro agosto 2026, le ore complessive lavorate dagli agenti sotto la supervisione dei dipendenti saranno sei volte quelle degli esseri umani. La maggior parte dei token è spesa per scrivere software, portando in sei mesi un aumento medio della velocità di invio del codice per ingegnere pari a cinque volte rispetto al livello iniziale.
Manus è simile. Il cofondatore Zhang Tao ha riferito che in un mese la spesa media pro capite per l’IA ha superato i 10.000 dollari, con alcuni individui che hanno speso tra 70.000 e 80.000 dollari mensilmente. Non tutta questa spesa riguarda i token, ma il significato è chiaro: non si tratta più di porre occasionalmente domande all’IA, bensì di gestire contemporaneamente un gruppo di agenti.
Un trilione di token può quindi essere considerato sia grande sia piccolo. Rispetto alle piattaforme IA è solo una frazione; ma per un’azienda di pagamenti quel trilione riguarda soltanto circa 1.400 sviluppatori, escludendo servizio clienti, conformità, controllo dei rischi e IA rivolta ai clienti. Vista così, la previsione di Adyen di arrivare a 100 trilioni di token all’anno non è affatto esagerata.
I token possono essere consumati, ma i conti vanno comunque saldati.
Un trilione di token non corrisponde a un importo fisso: i prezzi dei diversi modelli possono variare fino a cento volte. Secondo i prezzi API standard annunciati da OpenAI il 28 ottobre 2026, ipotizzando che l’80% dei token sia in input e il 20% in output: se tutti fossero usati con GPT-6 Luna, il costo teorico sarebbe di circa 180.000 dollari; se tutti fossero usati con GPT-6 Astra, il costo teorico sarebbe di circa 18 milioni di dollari.
Adyen utilizza effettivamente molti modelli diversi e dispone di propria infrastruttura di ragionamento, instradamento semantico e prezzi aziendali, quindi la fattura reale è certamente molto più complessa di questa semplice moltiplicazione. Un trilione di token può essere molto economico o molto costoso. Spendere tanto non significa necessariamente usarlo bene.
Una volta esauriti i token, le aziende devono rispondere ad alcune domande fondamentali: quanti codici sono stati completati senza incidenti? Quanti commercianti regolari sono stati giudicati erroneamente? Quanti ticket del servizio clienti sono stati risolti senza dover essere trasferiti nuovamente a un operatore umano? Nel gestire le contestazioni di pagamento, sono stati forniti i materiali corretti alle persone giuste?
C’è una domanda ancora più importante del costo: fino a che punto può spingersi l’IA? Aiutare il servizio clienti a verificare informazioni non comporta grandi rischi; aiutare gli ingegneri a scrivere codice permette comunque di eseguire test e revisioni; ma se si autorizzano gli agenti a muovere direttamente fondi, congelare account o rifiutare commercianti, il costo degli errori diventa completamente diverso.
Almeno per ora, le aziende di pagamenti non chiederanno a un modello linguistico su ogni singolo pagamento. Una divisione del lavoro più realistica è: il libro mastro continua a tenere i conti, regole e modelli dedicati continuano a valutare le transazioni, i modelli linguistici si occupano di leggere e scrivere codice, verificare informazioni e gestire eccezioni, mentre gli esseri umani rimangono nei ruoli dove gli errori hanno un costo più elevato.
Il denaro scorre come acqua, e così anche i token.
Fine dell’articolo
Questo articolo si basa esclusivamente su osservazioni e riflessioni personali e non costituisce alcun consiglio finanziario o commerciale. Si invita i lettori a valutare criticamente le proprie conoscenze e fonti informative.