Que fait l'IA de la société de paiement avec mille milliards de jetons par an ?
 Tapbit Wire
Le CTO d'Adyen a indiqué que l’entreprise compte environ 1 400 développeurs qui consomment près d’un millier de milliards de jetons chaque année. Ce chiffre a quadruplé ces trois derniers mois, et Adyen s’apprête à atteindre une consommation annuelle de cent mille milliards de jetons.
Où vont ces dépenses en jetons ? Que font-ils ?
Les mille milliards de jetons d'Adyen sont principalement consommés par l’équipe d’ingénierie. Chez d’autres sociétés de paiement, les jetons servent aussi aux examens des marchands, aux réponses du service client, au traitement des réclamations, à la lecture des e-mails et à l’investigation d’anomalies.
L’argent coule comme de l’eau, et les jetons aussi.
Les gens restent immobiles, tandis que les jetons continuent de tourner.
Au cours des 90 derniers jours, l’IA d’Adyen a modifié environ un million de documents et participé à 20 000 commits Git. Le nombre moyen de demandes de fusion a augmenté de 48 %, et les ingénieurs estiment que l’IA leur a permis de gagner environ 15 % de temps. Adyen estime que l’investissement en jetons a probablement généré un retour doublé.
Ils ont cité un exemple : Adyen possède un système de paiement backend chargé de la facturation, de la rapprochement et des rapports d’organisations cartes, comprenant environ 2 000 tâches en production liées à plus de quarante organisations cartes. L’ancien système était entièrement intégré dans une seule image de déploiement, et Adyen souhaitait le découper pour qu’chaque organisation carte dispose de son propre conteneur indépendant.
Selon les pratiques antérieures, ce projet aurait nécessité plusieurs équipes et pris de 6 à 12 mois. En fin de compte, deux ingénieurs, aidés par l’IA, l’ont mené à bien en deux mois, sans incident.
Voici comment l’Agent de codage consomme des jetons : il ne se contente pas de remplir quelques lignes de code ; il lit d’abord le code, puis la documentation, identifie les dépendances et exécute les tests. En cas d’échec, il analyse les messages d’erreur, modifie le code et relance les tests. Lorsqu’une personne lance plusieurs agents simultanément, ces étapes se répètent en arrière-plan. Les gens restent immobiles, tandis que les jetons continuent de tourner.
Stripe a également indiqué que 91 % de ses ingénieurs utilisent quotidiennement l’IA (on ignore pourquoi les 9 % restants n’ont pas été licenciés). L’agent interne de codage soumet plus de 1 000 demandes d’intégration (PR) hebdomadaires en production. En mars 2026 seulement, Stripe a enregistré plus de 57 000 PR utilisant l’assistance IA pour le codage, soit une hausse de 140 % en trois mois.
Block suit une tendance similaire : environ 7 500 employés utilisent l’IA chaque semaine, plus de 90 % des soumissions de code impliquent l’IA, et les modifications hebdomadaires moyennes de code ont augmenté de 30 %.
Actuellement, une part importante de la facture en jetons des sociétés de paiement provient du département ingénierie. L’usage de l’IA dans ce secteur ne se limite pas à écrire du code ex nihilo : son application la plus réaliste consiste à aider les humains à gravir la montagne de la complexité. Les systèmes de paiement sont vastes, comportent beaucoup de code hérité, et doivent s’adapter aux banques, aux organismes cartes et aux divers moyens de paiement. Cette complexité absorbait surtout le temps des ingénieurs, mais désormais l’IA y participe aussi, en consommant des jetons.
Rechercher des documents, rédiger des publicités, lire des contrats : tout cela consomme des jetons.
Écrire du code n’est qu’une partie de l’utilisation interne de l’IA. Une fintech légèrement plus grande passe beaucoup de temps chaque jour à chercher des informations : où se trouve la politique de remboursement ? Quelle équipe gère ces données ? Où demander l’accès à tel système ? À qui s’adresser pour une demande de congé ? Plus l’entreprise est grande, plus il y a de documents ; plus il y en a, plus il est facile de s’y perdre.
Nubank compte environ 9 000 employés, et chaque équipe stocke ses processus et documents dans Confluence. Lorsqu’un employé rencontre un problème, il peut passer jusqu’à trente minutes à chercher ; s’il ne trouve toujours pas, il ouvre un ticket et attend plusieurs heures. Nubank a ensuite développé un outil interne, AskNu, permettant aux employés de poser directement leurs questions sur Slack. AskNu identifie d’abord le département concerné, recherche la réponse dans les documents Confluence correspondants, puis synthétise la réponse à l’aide d’un grand modèle, avec le lien original inclus.
Six mois après son lancement, AskNu comptait 5 000 utilisateurs et traitait 280 000 messages. Nubank a indiqué qu’il avait réduit de 96 % certains tickets internes. Des problèmes qui nécessitaient auparavant 30 minutes de recherche ou une attente de 8 heures pour un ticket obtiennent désormais une réponse en moyenne en 9 secondes.
AskNu n’aide pas directement les clients à transférer de l’argent ni à traiter des paiements, mais lit continuellement les questions, récupère les documents pertinents et organise les réponses. Chaque employé pose quelques questions par jour, et les jetons s’accumulent progressivement.
L’équipe éditoriale suit la même approche. Chime a baptisé très simplement son modèle interne de contenu : ChimeGPT. Elle a également créé un « cerveau de marque », intégrant des récits antérieurs sur la marque, des retours utilisateurs, des résultats de campagnes et des échanges communautaires. L’équipe marketing l’utilise pour générer différentes versions de contenus et des parcours d’intégration personnalisés, soumis ensuite aux validations marque, juridique et conformité.
Chime a révélé que la production éditoriale interne a augmenté de plus de 300 % en glissement annuel, tandis que le temps de production a été réduit de 60 %. Ce qui prenait autrefois dix heures, de la conception à la campagne, peut désormais être réalisé en environ quatre heures, avec un volume de tests triplé. Les données organisationnelles de Klarna sont également remarquables : 90 % des employés utilisent quotidiennement l’IA générative, avec des taux d’utilisation atteignant respectivement 93 %, 88 % et 86 % au sein des équipes de communication, marketing et juridique.
Écrire du code consomme des jetons, tout comme rédiger des publicités, traduire des documents, résumer des réunions, lire des contrats ou répondre aux questions de collègues.
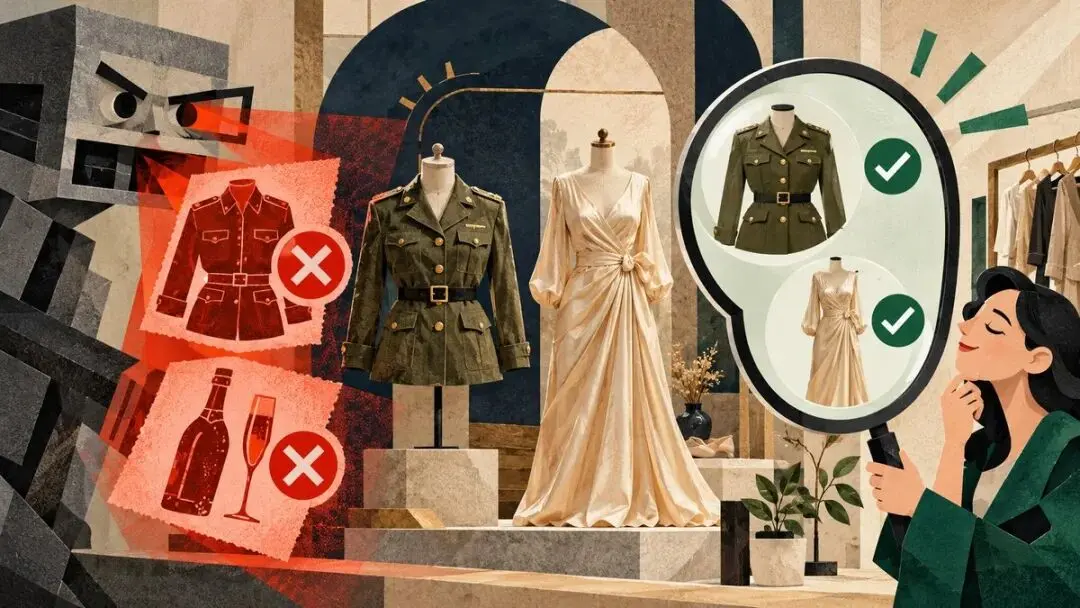
Une « robe couleur champagne » ne signifie pas vendre de l’alcool.
Les sociétés de paiement accomplissent quotidiennement une tâche proche de la vérification d’identité : Qui est cette personne ? Que vend-elle exactement ? Peut-on la laisser entrer et percevoir des paiements ?
Les commerçants ne se présentent certes pas honnêtement selon les formulaires des sociétés de paiement. Les indices sont disséminés sur les sites officiels, les pages produits, les documents d’inscription et les articles de presse, parfois dans différentes langues. Les anciens systèmes manquaient de patience face à cette complexité, et la méthode la plus simple consistait à rechercher des mots-clés.
Airwallex a fourni un exemple humoristique : un commerçant vend une « veste style militaire », et le système détecte « militaire », ce qui peut le conduire à soupçonner la vente de biens militaires interdits ; un autre écrit « robe couleur champagne », et le système repère « champagne », ce qui pourrait le faire croire à une vente d’alcool.
Une personne perçoit immédiatement qu’une veste style militaire n’est pas une arme, et qu’il n’y a pas de champagne dans une robe couleur champagne. Mais les mots-clés ne comprennent ni les couleurs ni la mode ; ils ne savent que ce mot semble un peu risqué.
C’est précisément là que les grands modèles excellent : non seulement ils ne se concentrent pas sur un seul mot, mais lisent d’abord le contexte environnant, puis déterminent ce que le commerçant vend réellement. Airwallex affirme qu’après avoir intégré l’IA générative dans ses procédures KYC, le taux moyen de faux positifs a diminué de 50 %, et le nombre de clients pouvant finaliser leur intégration sans intervention humaine a augmenté de 20 %.
Stripe a aussi commencé à utiliser des LLM pour l’intégration des commerçants en 2023. Il ne permet pas au grand modèle d’approuver tous les commerçants, mais traite d’abord les informations ouvertes et non structurées, et accélère le traitement des demandes clairement conformes. Plus de 80 % des « commerçants éligibles » peuvent être approuvés automatiquement en temps réel. Le délai d’examen des politiques chez Checkout.com est passé de 60 à 10 minutes.
Auparavant, les employés devaient ouvrir des pages web, lire les documents, vérifier les politiques et rédiger eux-mêmes des conclusions ; désormais, le grand modèle effectue une lecture préliminaire et met en évidence les points nécessitant une attention humaine. Les jetons consommés ici se traduisent par moins de faux positifs, des ouvertures de compte plus rapides et moins de temps consacré par le personnel interne à des documents parfaitement conformes.
Même une tasse de café à cinq dollars passe par la finance.
Les sociétés de paiement aident autrui à gérer de l’argent, mais en interne, elles doivent encore rembourser, auditer les dépenses, relancer les factures et tenir la comptabilité. C’est probablement le type de produit fintech IA le plus discret. Lorsqu’un employé utilise une carte entreprise pour acheter un café, il doit souvent télécharger un reçu, préciser l’objet de la dépense et sélectionner une catégorie ; les managers doivent valider son caractère professionnel, la finance vérifier la conformité aux règles, réaliser le codage comptable, puis synchroniser l’information dans l’ERP. Le montant peut ne représenter que cinq dollars, mais le coût en temps de traitement est souvent supérieur.
Ramp a conçu un « Agent politique » spécifiquement dédié à l’audit de ce type de dépenses. Il vérifie la cohérence entre le reçu et la transaction, la présence de remboursements en double, la clarté de l’objet, le respect de la politique interne et d’éventuelles anomalies récentes dans les dépenses de l’employé. Les dépenses conformes peuvent être automatiquement proposées à l’approbation, tandis que les cas problématiques sont transmis à un humain. Ramp affirme que ses premiers clients ont réduit leurs revues manuelles d’environ 85 %, avec un taux de précision supérieur à 99 % dans l’application des politiques de dépenses, l’autorité finale d’approbation restant toutefois dévolue au réviseur.
Brex Assistant gère des tâches encore plus minutieuses : il retrouve automatiquement les reçus, rédige des notes, remplit les catégories de dépenses et les participants, et interroge proactivement les employés sur les dépenses non conformes. Brex donne cet exemple : un reçu peut mentionner « vodka » sans préciser « alcool ». Les anciennes règles basées sur les mots-clés auraient pu passer à côté, mais le grand modèle sait que la vodka est considérée comme de l’alcool.
Ce genre de travail convient parfaitement à l’échange de jetons contre du temps.
Les analystes LCB passent la majeure partie de leur temps non pas à démasquer des fraudeurs.
Les sociétés de paiement génèrent quotidiennement un grand nombre d’alertes de risque. Peu de transactions sont réellement suspectes, mais chaque alerte exige qu’un humain l’ouvre, vérifie les infos client, passe en revue les transactions historiques, examine les comptes associés, puis rédige un paragraphe justifiant sa clôture ou son escalade. Beaucoup d’analystes LCB ne traquent pas les fraudeurs : ils prouvent plutôt qu’une personne ne présente actuellement aucun signe de fraude.
Nexo utilise l’agent IA de Unit21 pour les premiers examens d’alertes. Cet agent structure les données de transaction et de compte, analyse les liens entre adresses et génère des synthèses d’enquête ainsi que des avis de traitement. Les analystes ne partent plus de zéro, mais vérifient les éléments et conclusions fournis par l’IA.
Dans l’étude de cas publiée conjointement par Unit21 et Nexo, il est indiqué que le taux de faux positifs de Nexo a baissé de 93 % par rapport à son ancien système interne ; aujourd’hui, 57 % des examens d’alertes sont automatisés par l’IA, avec pour objectif d’atteindre 80 %. Ce chiffre mérite attention : il provient d’une étude commune fournisseur-client, non d’un audit indépendant ; Unit21 n’a pas divulgué le nombre de jetons consommés par enquête.
Ce cas illustre clairement le rôle de l’IA en matière de LCB : la machine rassemble les éléments, cartographie les liens et rédige le récit ; l’humain juge ensuite si le cas est réellement suspect et s’il faut le signaler aux autorités.
Un client demande simplement : « Où est mon argent ? »
Le service client des sociétés de paiement n’est pas toujours aussi simple que « aidez-moi à changer mon mot de passe ». Quand un client demande « Pourquoi l’argent n’est-il pas arrivé ? », cela peut impliquer la banque acquéreuse, l’organisme cartes, la banque émettrice, la conversion devises, le cycle de règlement, l’état d’un remboursement ou des restrictions sur le compte. Les conseillers doivent consulter plusieurs systèmes et reconstituer l’information pour donner une réponse cohérente.
Les agents IA suivent le même processus : comprendre le problème, interroger la transaction, récupérer les règles, déterminer l’étape suivante, puis générer une réponse. À chaque requête vers un système, les résultats doivent être renvoyés au modèle, consommant des jetons itérativement.
Checkout.com indique qu’environ 60 % des demandes client sont des questions simples et répétitives ; d’ici 2026, les agents IA devraient traiter plus de la moitié du volume client. Block précise que 65 % des dossiers Cash App utilisent déjà l’IA. Klarna va plus loin : son assistant IA a servi plus de 4 millions de clients au premier semestre 2024, avec un gain annuel prévu de 40 M$.
Le calcul des jetons consommés en service client est simple : auparavant, un certain nombre de personnes traitait un certain nombre de tickets ; désormais, un certain nombre de jetons traite ce même volume, et on peut mesurer les transferts vers un humain ou les réouvertures par le client.
Il en va de même pour les réclamations et litiges. Stripe reçoit de nombreux e-mails automatisés de ses partenaires financiers, qui nécessitaient auparavant une lecture manuelle puis un traitement dans le système ; désormais, les LLM lisent ces e-mails, comprennent la demande et transforment celle-ci en appels API. Checkout.com affirme aussi avoir automatisé à 100 % la répartition des transactions refusées, autrefois réalisée manuellement.
Ces tâches peuvent sembler moins spectaculaires que « l’IA transforme la finance », mais elles sont chronophages et parfaitement adaptées à la consommation de jetons.
Quand l’IA parle en consultant vos avoirs
Les IA mentionnées précédemment sont surtout invisibles pour les clients : elles opèrent en arrière-plan, dans les codes, audits et systèmes client. Robinhood Cortex est différent : il apparaît directement sur les smartphones des investisseurs.
Lorsqu’un utilisateur ouvre une action, Cortex consulte les cours en temps réel, les actualités brèves, les rapports d’analystes, les indicateurs techniques et les données propres à Robinhood, puis explique, en termes simples, pourquoi cette action monte ou baisse ce jour. Il croise aussi ces infos avec les avoirs de l’utilisateur pour préciser pourquoi cette actualité concerne son compte.
Robinhood a révélé que près d’un million de clients avaient utilisé les « Cortex Digests » au premier trimestre 2026. La prochaine étape consiste à permettre aux utilisateurs d’acheter/vendre des actions et cryptomonnaies, d’analyser les marchés et d’ajuster leurs paramètres de compte via le langage naturel.
À ce stade, ce ne sont plus seulement les employés qui consomment des jetons : chaque question posée par un utilisateur déclenche la lecture d’une actualité ou d’un rapport, et chaque interprétation personnalisée selon ses avoirs exige un nouveau traitement du contexte.
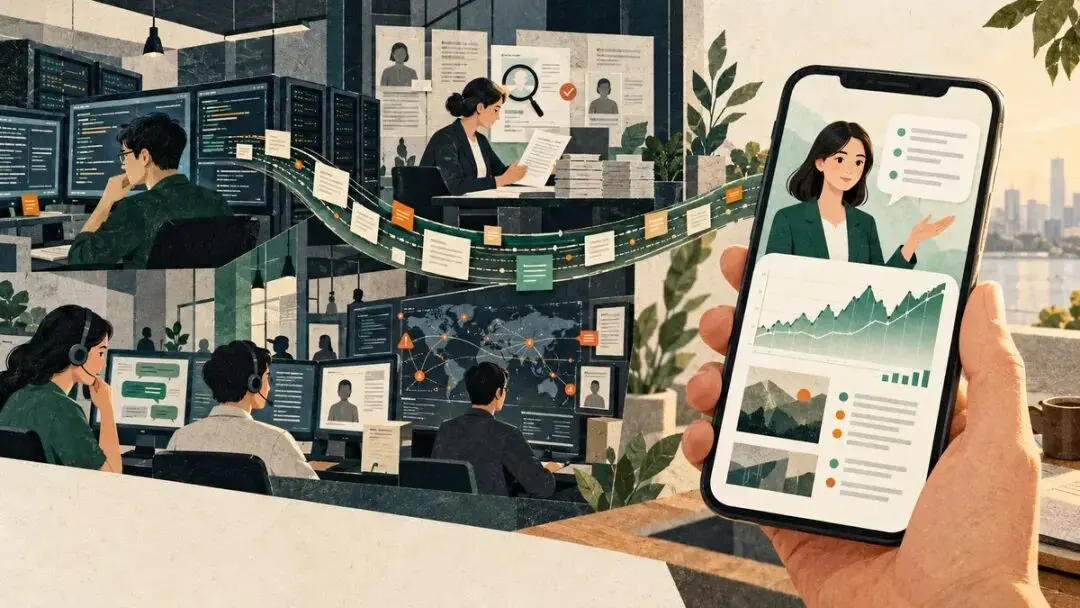
Le vrai problème survient quand l’IA agit au nom des utilisateurs : le coût des erreurs change. Une mauvaise information peut induire en erreur ; une mauvaise commande boursière fait perdre de l’argent réel. Robinhood a donc fixé des limites strictes à Cortex : ce qu’il peut voir, ce qu’il peut dire, et quelles actions exigent une confirmation explicite de l’utilisateur.
Mille milliards de jetons : que signifie cela pour les entreprises d’IA ?
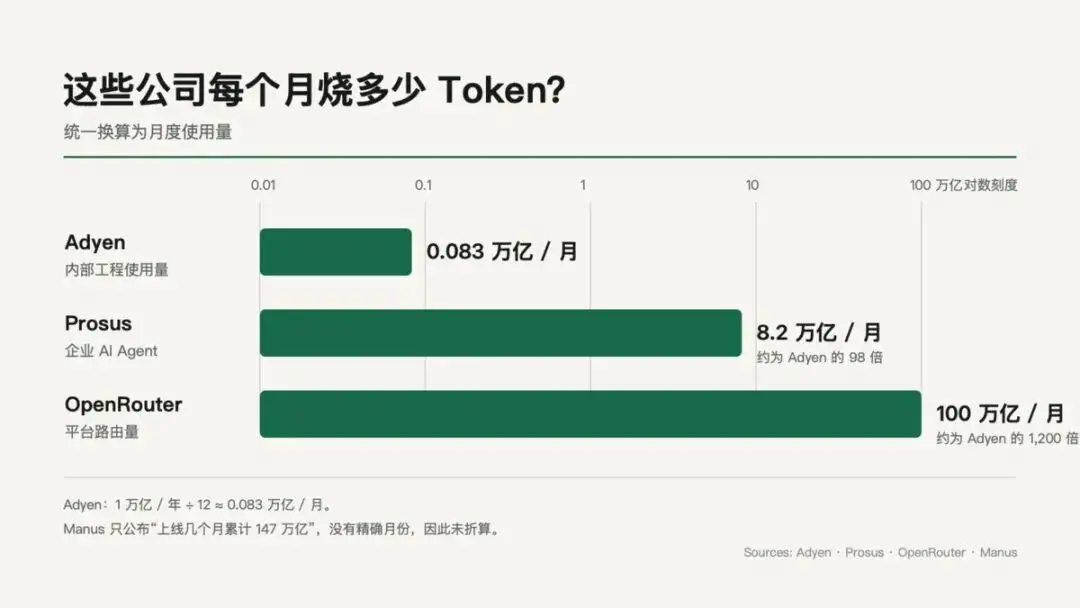
D’abord, examinons Adyen elle-même : environ 1 400 développeurs y consomment 1 billion de jetons par an, soit en moyenne 710 millions par personne. Sur 250 jours ouvrables, cela représente environ 2,86 millions de jetons par personne et par jour. Ce n’est plus simplement faire remplir occasionnellement quelques lignes de code par l’IA ; c’est avoir un agent qui travaille toute la journée.
Mais dès que ce chiffre est mis en perspective dans le secteur de l’IA, l’unité de mesure change rapidement.
Le produit de Manus est en ligne depuis quelques mois et a traité plus de 147 billions de jetons — l’équivalent de la consommation d’Adyen sur 147 ans. OpenRouter achemine désormais 100 billions de jetons par mois, soit l’équivalent de la consommation annuelle de 100 sociétés comme Adyen, chaque mois. Certes, ce sont des plateformes desservant un très grand nombre de clients, et non comparables directement à une équipe interne d’ingénieurs, mais l’ordre de grandeur de la différence est frappant.
Prenons une entreprise plus typique : Prosus, qui gère de nombreuses activités e-commerce et internet, déploie des agents IA pour 40 000 employés, 5 millions de partenaires et 1 milliard d’utilisateurs. Elle consomme 82 billions de jetons par mois — soit la quantité annuelle d’Adyen en seulement quatre jours. Sa consommation de jetons a augmenté de 52 fois au cours de l’année écoulée.
OpenAI n’a pas révélé sa consommation annuelle de jetons, mais a indiqué les dépenses autorisées aux chercheurs. D’ici août 2026, le coût médian quotidien de calcul pour un chercheur (selon les tarifs API) dépassera 600 $ ; les 10 % les plus dépensiers dépasseront 7 000 $ par jour. Sur 250 jours ouvrables, cela représente 150 000 $ par personne, voire 1,75 million $ pour les gros utilisateurs.
Anthropic adopte une approche plus directe : elle ne mesure pas l’argent, mais le temps de travail. D’ici août 2026, les heures cumulées de travail des agents sous la supervision des employés seront six fois supérieures à celles des humains. La majorité des jetons sont consommés pour écrire du code, ce qui accroît en moyenne la vitesse de soumission de code par ingénieur de cinq fois en six mois.
Manus suit une tendance similaire. Son cofondateur Zhang Tao a mentionné qu’un mois donné, la dépense moyenne en IA par personne a dépassé 10 000 $, certains individus atteignant 70 000 à 80 000 $ mensuels. Tout cela ne correspond pas uniquement au coût des jetons, mais le message est clair : on ne pose plus simplement des questions occasionnelles à l’IA, mais on gère simultanément plusieurs agents.
Ainsi, un billion de jetons peut paraître à la fois énorme et modeste : insignifiant face aux plateformes IA, mais considérable pour une société de paiement où ce billion concerne seulement environ 1 400 développeurs — sans compter le service client, la conformité, la gestion des risques ni les IA destinées aux clients. Dans cette optique, préparer Adyen à 100 billions de jetons par an n’est pas exagéré.
Les jetons peuvent être consommés, mais les factures doivent tout de même être réglées.
Un billion de jetons ne correspond pas à une facture fixe : les prix des modèles varient jusqu’à cent fois. Selon les tarifs API standard d’OpenAI annoncés le 28 octobre 2026, en supposant 80 % de jetons en entrée et 20 % en sortie : si tous étaient traités avec GPT-6 Luna, le coût théorique serait d’environ 180 000 $ ; avec GPT-6 Astra, il atteindrait environ 18 millions $.
Adyen utilise en réalité de nombreux modèles différents, possède son propre infrastructure de raisonnement, un routage sémantique et des tarifs entreprises : sa facture réelle est donc bien plus complexe que cette simple multiplication. Un billion de jetons peut être très peu coûteux… ou très cher. Dépenser beaucoup ne signifie pas nécessairement bien utiliser.
Une fois les jetons épuisés, les entreprises doivent répondre à des questions fondamentales : combien de lignes de code ont été produites sans incident ? Combien de commerçants normaux ont été jugés à tort ? Combien de tickets service client ont été résolus sans transfert vers un agent humain ? En cas de contestation de paiement, les documents appropriés ont-ils été fournis aux bonnes personnes ?
Une question prime toutes les autres : jusqu’où l’IA peut-elle aller ? Aider le service client à vérifier des informations comporte peu de risques ; aider les ingénieurs à écrire du code reste contrôlable via tests et relectures ; mais si les agents peuvent directement transférer des fonds, geler des comptes ou rejeter des commerçants, le coût des erreurs devient totalement différent.
Pour l’instant, les sociétés de paiement ne demandent pas à un modèle de langage de traiter chaque paiement. Une répartition plus réaliste du travail est la suivante : le grand livre continue de tenir la comptabilité, les règles et modèles spécialisés jugent toujours les transactions, les grands modèles lisent, écrivent du code, vérifient des informations et gèrent les exceptions, tandis que les humains restent en première ligne là où les erreurs seraient particulièrement coûteuses.
L’argent coule comme de l’eau — et les jetons aussi.
Fin de l’article
Cet article repose uniquement sur des observations et réflexions personnelles et ne constitue aucun conseil en investissement ou en affaires. Les lecteurs sont invités à juger rationnellement en fonction de leur propre compréhension et de leurs sources d’information.