¿Qué hace la IA de la empresa de pagos con un billón de tokens al año?
 Tapbit Wire
El CTO de Adyen afirmó que la empresa tiene unos 1400 desarrolladores que consumen aproximadamente un billón de tokens al año. En los últimos tres meses, esta cifra se ha cuadruplicado y Adyen ha comenzado a prepararse para un consumo anual de cien billones de tokens.
¿Dónde va su gasto en tokens? ¿Qué están haciendo?
Los mil millones de tokens de Adyen se consumen principalmente por el equipo de ingeniería. En otras empresas de pagos, los tokens también se usan para revisar comerciantes, responder al servicio al cliente, gestionar devoluciones, leer correos electrónicos e investigar anomalías.
El dinero fluye como el agua, y los tokens también.
Las personas permanecen sentadas sin moverse, mientras los tokens siguen corriendo.
En los últimos 90 días, la IA de Adyen ha editado unos un millón de documentos y participado en 20 000 commits en Git. La solicitud media de fusión de la empresa aumentó un 48 % y los ingenieros estiman que la IA les ha ahorrado cerca del 15 % de su tiempo. Adyen considera que la inversión en tokens probablemente generó un retorno del doble.
Compartieron un ejemplo: Adyen tiene un sistema de pagos backend responsable de facturación, conciliación y reportes de organizaciones tarjetarias, con unas 2000 tareas en producción que involucran más de cuarenta organizaciones tarjetarias. El sistema original estaba todo integrado en una única imagen de despliegue, y Adyen quería dividirlo para que cada organización tarjetaria tuviera su propia imagen independiente.
Siguiendo prácticas anteriores, este proyecto requeriría varios equipos y tomaría entre 6 y 12 meses. Al final, dos ingenieros trabajaron con IA y lo completaron en dos meses, sin incidencias.
Así es aproximadamente cómo el Agente de Codificación consume tokens: no solo rellena unas líneas de código, sino que primero lee el código, luego la documentación, identifica dependencias y ejecuta pruebas. Si estas fallan, analiza los mensajes de error, modifica el código y vuelve a ejecutarlo. Cuando una persona abre varios agentes simultáneamente, estos procesos se repiten continuamente en segundo plano. Las personas permanecen sentadas sin moverse, mientras los tokens siguen corriendo.
Stripe también señaló que el 91 % de sus ingenieros usa IA en su trabajo diario (no está claro por qué al 9 % restante no se le ha despedido). El agente interno de codificación envía más de 1000 solicitudes de extracción (PR) al entorno productivo cada semana. Solo en marzo de 2026, Stripe registró más de 57 000 PR con asistencia de IA, un aumento del 140 % en tres meses.
Block es similar: unos 7500 empleados usan IA semanalmente y más del 90 % de los envíos de código implican participación de IA, con un aumento del 30 % en los cambios semanales de código.
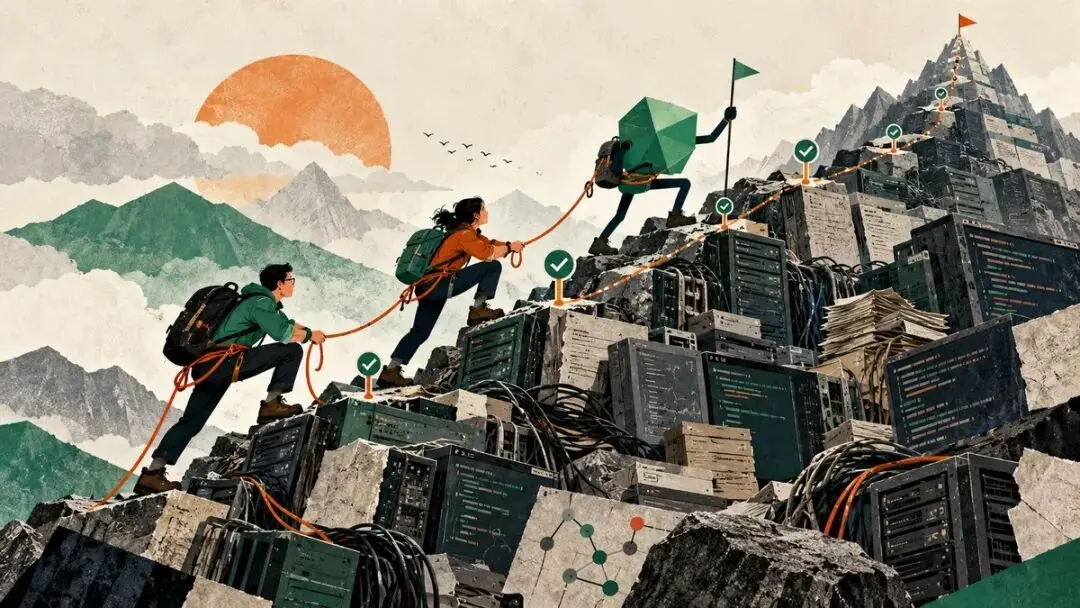
Actualmente, parece que gran parte de la factura de tokens de las empresas de pagos proviene del departamento de ingeniería. El uso de IA en el sector no se limita a escribir código nuevo desde cero; una aplicación más realista consiste en ayudar a los humanos a escalar la montaña de complejidad. Los sistemas de pagos son extensos, con mucho código heredado, y deben adaptarse a bancos, organizaciones tarjetarias y diversos métodos de pago. Antes, esta complejidad consumía sobre todo tiempo de ingenieros; ahora también se incorpora IA para ayudar, consumiendo tokens.
Buscar documentos, redactar anuncios o leer contratos también consume tokens.
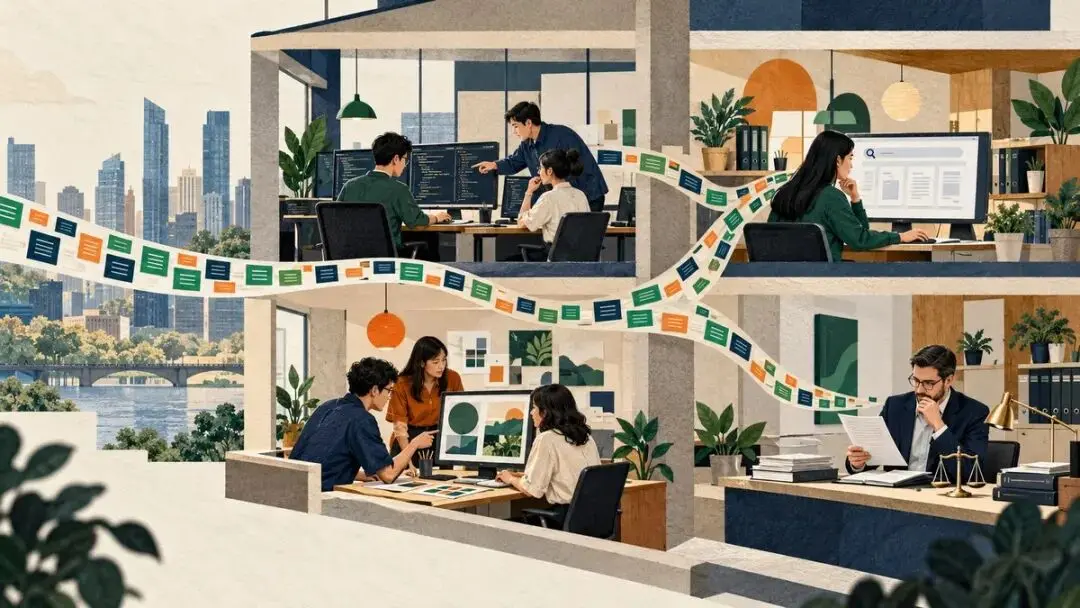
Escribir código es solo una parte del uso interno de IA. Una fintech ligeramente mayor dedica mucho tiempo diario a buscar información: ¿dónde está la política de reembolsos? ¿Qué equipo gestiona estos datos? ¿Dónde solicito permisos para cierto sistema? ¿A quién contacto para pedir vacaciones? Cuanto mayor sea la empresa, más documentos tendrá; y cuanto más documentos haya, más fácil será perderse.
Nubank tiene unos 9000 empleados, y distintos equipos alojan sus procesos y documentos en Confluence. Cuando los empleados tienen problemas, pueden tardar hasta media hora en encontrar la información; si aún no la hallan, abren un ticket y esperan varias horas. Luego, Nubank creó una herramienta interna llamada AskNu, donde los empleados pueden hacer preguntas directamente en Slack. AskNu primero determina el departamento correspondiente, busca la respuesta en los documentos de Confluence y, finalmente, organiza una respuesta mediante un modelo grande, incluyendo el enlace original.
Seis meses después del lanzamiento, AskNu tenía 5000 usuarios y gestionaba 280 000 mensajes. Nubank afirmó que redujo algunos tickets internos en un 96 %. Problemas que antes tardaban 30 minutos en resolverse o requerían esperar 8 horas para un ticket ahora obtienen respuestas en promedio en 9 segundos.
AskNu no ayuda directamente a los clientes a transferir dinero ni procesar pagos, pero lee continuamente preguntas, recupera documentos y organiza respuestas. Cada persona de la empresa formula unas pocas preguntas al día, y los tokens se acumulan poco a poco.
El equipo de contenido es el mismo. Chime bautizó a su modelo interno de contenido de forma muy directa: ChimeGPT. También creó un «cerebro de marca» que incluye historias anteriores de la marca, comentarios de usuarios, resultados de campañas y debates comunitarios. El equipo de marketing lo usa para generar distintas versiones de contenido y procesos de incorporación personalizados, que luego pasan por revisiones de marca, legales y de cumplimiento.
Chime reveló que la producción de contenido del equipo interno aumentó más del 300 % interanual y el tiempo de producción se redujo un 60 %. Lo que antes tomaba diez horas desde el concepto hasta la campaña ahora se completa en unas cuatro horas, triplicándose además el volumen de pruebas. Los datos organizacionales de Klarna también son interesantes: el 90 % de los empleados usan IA generativa a diario, con tasas de uso del 93 %, 88 % y 86 % en los equipos de comunicaciones, marketing y legal, respectivamente.
Escribir código consume tokens, al igual que redactar anuncios, traducir materiales, resumir reuniones, leer contratos y responder preguntas de colegas.
Un vestido «de color champán» no implica vender alcohol.
Las empresas de pagos realizan diariamente una tarea similar a verificar identidades: ¿quién es esta persona? ¿Qué está vendiendo exactamente? ¿Podemos permitirle ingresar y cobrar dinero?
Los comerciantes ciertamente no se presentan con honestidad según los formularios de la empresa de pagos. Las pistas están dispersas en sitios web oficiales, páginas de productos, documentos de registro y artículos de prensa, y pueden estar escritas en distintos idiomas. Los sistemas anteriores carecían de paciencia ante tal complejidad, y el método más sencillo era buscar palabras clave.
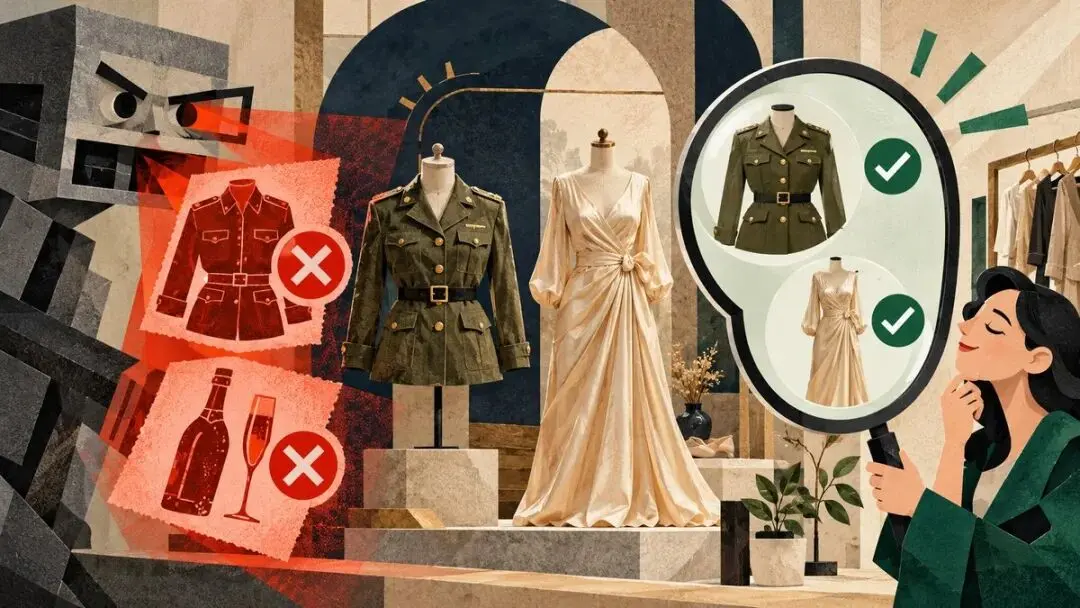
Airwallex dio un ejemplo humorístico: un comerciante vende una «chaqueta estilo militar», y el sistema detecta «militar», lo que podría hacerlo sospechar que vende artículos militares prohibidos; otro comerciante escribe «vestido de color champán», y el sistema ve «champán», lo que podría llevarlo a pensar que vende alcohol.
Una persona puede distinguir al instante que una chaqueta estilo militar no es un arma ni que hay champán en un vestido de color champán. Pero las palabras clave no entienden colores ni moda; solo saben que esa palabra parece algo peligrosa.
Esto es precisamente lo que los modelos grandes hacen mejor: no centrarse únicamente en una palabra, sino leer primero el contexto circundante y luego identificar qué vende realmente el comerciante. Airwallex señaló que, tras integrar la IA generativa en los procesos KYC, la tasa media de falsos positivos disminuyó un 50 % y el número de clientes que pudieron completar su incorporación sin intervención humana aumentó un 20 %.
Stripe también comenzó a usar modelos de lenguaje grande (LLM) para la incorporación de comerciantes en 2023. No permite que el modelo grande apruebe a todos los comerciantes; en cambio, primero procesa información abierta y no estructurada y aprueba rápidamente las solicitudes que claramente cumplen los requisitos. Más del 80 % de los «comerciantes elegibles» pueden ser aprobados automáticamente al instante. La revisión de políticas de Checkout.com se acortó de 60 a 10 minutos.
Antes, los empleados debían abrir páginas web, leer materiales, consultar políticas y redactar conclusiones ellos mismos; ahora, el modelo grande lee primero y resalta las áreas que requieren atención humana. Los tokens consumidos aquí se traducen en menos falsos positivos, aperturas de cuentas más rápidas y menos tiempo invertido por el personal interno en materiales que no presentan problemas.
Incluso una taza de café de cinco dólares debe pasar por finanzas.
Las empresas de pagos ayudan a otros a manejar dinero, pero internamente aún deben reembolsar gastos, auditar facturas, reclamar recibos y realizar contabilidad. Este puede ser el tipo más discreto de producto de IA fintech. Cuando un empleado usa la tarjeta corporativa para comprar una taza de café, quizás deba subir un comprobante, especificar su finalidad y seleccionar una categoría de gasto; los gerentes deben confirmar si fue para trabajo, finanzas debe verificar la política, aplicar codificación contable y sincronizarla con el ERP. El monto puede ser solo cinco dólares, pero el costo laboral para procesarlo suele ser mayor.
Ramp creó un Agente de Políticas específicamente para auditar este tipo de gastos. Verifica si el comprobante y la transacción coinciden, si hay reembolsos duplicados, si la finalidad está claramente indicada, si viola la política de la empresa y si el empleado ha tenido gastos inusuales recientemente. Los gastos conformes pueden sugerirse automáticamente para aprobación, mientras que los problemáticos se derivan a un humano. Ramp afirma que sus primeros clientes redujeron las revisiones manuales en un ~85 %, con una tasa de precisión superior al 99 % en la aplicación de políticas de gastos, aunque la autoridad final de aprobación sigue correspondiendo al revisor.
Brex Assistant gestiona tareas aún más rutinarias: encuentra automáticamente recibos, redacta memorandos, completa categorías de gastos y asistentes, y cuestiona proactivamente a los empleados sobre gastos no conformes. Brex dio un ejemplo: un comprobante puede no mencionar «alcohol», sino solo «vodka». Las reglas anteriores basadas en palabras clave podrían no detectarlo, pero el modelo grande sabe que el vodka cuenta como alcohol.
Este tipo de trabajo es ideal para intercambiar tokens por tiempo.
Los analistas de AML pasan la mayor parte de su tiempo no atrapando a delincuentes.
Las empresas de pagos generan diariamente una gran cantidad de alertas de riesgo. Es posible que haya pocas transacciones verdaderamente sospechosas, pero cada alerta requiere que alguien la abra, revise la información del cliente, analice las transacciones históricas, examine cuentas relacionadas y redacte un párrafo explicando por qué cerrarla o elevarla. Muchos analistas de AML no dedican su tiempo a atrapar a delincuentes, sino a demostrar que una persona actualmente no parece serlo.
Nexo utiliza el Agente IA de Unit21 para revisiones preliminares de alertas. El agente organiza información de transacciones y cuentas, analiza relaciones entre direcciones y genera resúmenes de investigación y opiniones sobre su manejo. Los analistas ya no parten de cero, sino que revisan los materiales y conclusiones proporcionados por la IA.
En el estudio de caso publicado conjuntamente por Unit21 y Nexo se menciona que la tasa de falsos positivos de Nexo disminuyó un 93 % respecto al sistema interno anterior, y actualmente el 57 % de las revisiones de alertas las realiza automáticamente la IA, con una meta de alcanzar el 80 %. Estos datos merecen atención: provienen de un caso publicado conjuntamente por el proveedor y el cliente, no de una auditoría independiente; Unit21 no ha revelado cuántos tokens se consumen por investigación.
No obstante, este caso ilustra claramente lo que la IA puede hacer en AML: la máquina recopila los datos, mapea las relaciones y redacta la narrativa; los humanos deciden si es realmente sospechosa y si debe reportarse a las autoridades reguladoras.
Un cliente simplemente preguntó: «¿Dónde está mi dinero?»
El servicio al cliente en empresas de pagos no siempre es tan sencillo como «ayúdeme a cambiar mi contraseña». Cuando un cliente pregunta «¿por qué aún no ha llegado el dinero?», puede implicar al banco adquirente, a la organización de tarjetas, al banco emisor, a la conversión de divisas, al ciclo de liquidación, al estado de reembolsos y a restricciones de cuenta. Los agentes deben consultar múltiples sistemas y ensamblar la información para dar una respuesta coherente.
Los Agentes IA siguen el mismo proceso: primero comprenden el problema, luego consultan la transacción, recuperan reglas, determinan el siguiente paso y generan una respuesta. Cada vez que se consulta un sistema, los resultados deben enviarse de vuelta al modelo, consumiéndose tokens repetidamente.
Checkout.com indica que aproximadamente el 60 % de las solicitudes de servicio al cliente son preguntas simples y repetitivas, y prevé que, para 2026, los Agentes IA gestionarán de forma autónoma más de la mitad del volumen total. Block reveló que cerca del 65 % de los casos de servicio al cliente en Cash App ya usan IA. Los datos de Klarna son aún más contundentes: su Asistente IA atendió a más de 4 millones de clientes en el primer semestre de 2024 y estima ahorrar 40 millones de dólares anuales.
El cálculo de tokens usados en servicio al cliente es directo: antes, cierto número de personas manejaba cierta cantidad de tickets; ahora, cierta cantidad de tokens gestiona esa misma cantidad, y se puede medir si hubo derivación a agentes humanos o si el cliente reabrió el caso.
Lo mismo ocurre con las devoluciones y gestión de disputas. Stripe recibe numerosos correos electrónicos automatizados de sus socios financieros, que antes requerían que empleados los leyeran uno a uno y los procesaran manualmente en el sistema; ahora, los LLM pueden leerlos primero, entender qué solicita la otra parte y convertir esas peticiones en llamadas API. Checkout.com también señaló que la distribución de transacciones rechazadas, que antes dependía de completarse manualmente, ahora está al 100 % automatizada.
Estas tareas quizá no suenen tan ambiciosas como «la IA transformando las finanzas», pero sí son muy exigentes en tiempo y adecuadas para consumir tokens.
Cuando la IA empieza a hablar mientras observa sus inversiones
Las IAs mencionadas anteriormente son mayormente invisibles para los clientes. Operan tras bambalinas, en código, auditorías y sistemas de servicio al cliente. Robinhood Cortex es distinto: aparece directamente en los teléfonos de los inversores.
Al abrir una acción, Cortex lee cotizaciones en tiempo real, noticias relevantes, informes de analistas, indicadores técnicos y datos propios de Robinhood, y explica en términos sencillos por qué la acción sube o baja ese día. Además, combina esta información con las inversiones del usuario para explicarle por qué dicha noticia afecta su cuenta.
Robinhood reveló que, para el primer trimestre de 2026, casi 1 millón de clientes habían usado los «Digests» de Cortex. El siguiente paso es permitir a los usuarios comprar y vender acciones y criptomonedas, investigar el mercado y ajustar la configuración de su cuenta directamente mediante lenguaje natural.
En este punto, ya no solo los empleados de la empresa consumen tokens: cada vez que un usuario formula una pregunta, Cortex lee una noticia o informe de investigación, y cada vez que lo interpreta nuevamente según las inversiones personales, debe procesar de nuevo el contexto.
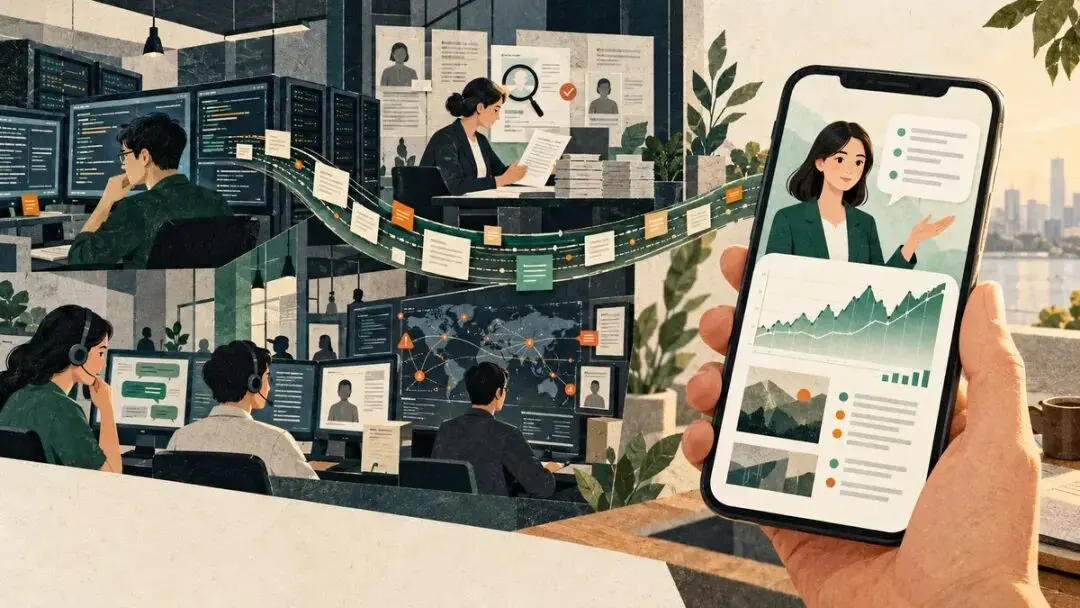
El verdadero problema surge cuando la IA actúa en nombre de los usuarios: el costo de los errores cambia. Si se informa mal una noticia, el usuario podría quedar simplemente desinformado; pero si se compra una acción incorrectamente, se pierde dinero real. Por eso, Robinhood también ha establecido límites claros para Cortex: qué puede ver, qué puede decir y qué acciones exigen confirmación explícita del usuario.
¿Qué significa un billón de tokens para las empresas de IA?
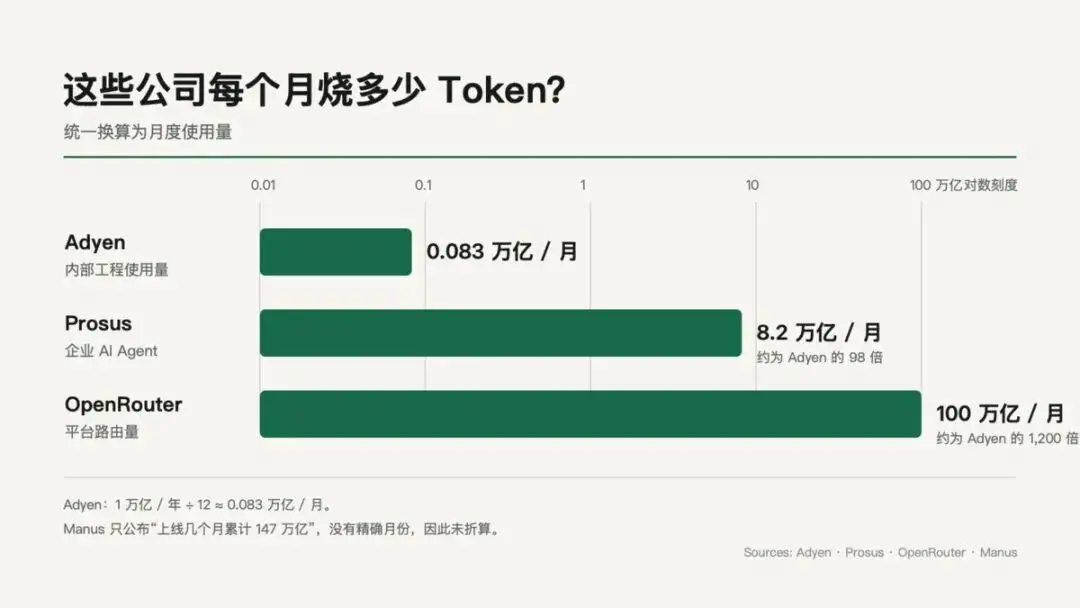
Primero, analicemos a Adyen: unos 1400 desarrolladores usan 1 billón de tokens anuales, unos 710 millones por persona. Suponiendo 250 días laborables, eso equivale a unos 2,86 millones de tokens por persona al día. Ya no se trata solo de que la IA complete ocasionalmente unas líneas de código, sino de tener un agente trabajando todo el día.
Pero al situar esta cifra en el sector de la IA, la unidad de medida cambia rápidamente.
El producto de Manus lleva unos meses activo y ha procesado más de 147 billones de tokens, equivalente al consumo de Adyen durante 147 años. OpenRouter ahora enruta 100 billones de tokens mensuales, lo que equivale al uso anual de 100 empresas como Adyen cada mes. Por supuesto, estas plataformas atienden a muchos clientes y no son directamente comparables con un equipo interno de ingeniería, pero la magnitud de la diferencia es muy clara.
Consideremos una empresa típica: Prosus, con múltiples operaciones de comercio electrónico e internet, donde agentes de IA atienden a 40 000 empleados, 5 millones de socios y 1000 millones de usuarios. Consume 82 billones de tokens al mes, lo que equivale al volumen anual de Adyen cada cuatro días. En el último año, su uso de tokens creció 52 veces.
OpenAI no ha revelado su consumo anual de tokens, pero sí ha indicado los gastos computacionales de los investigadores. Para agosto de 2026, el costo computacional diario mediano por investigador, según los precios de la API, superará los 600 USD. El 10 % superior podrá gastar más de 7000 USD diarios. Suponiendo 250 días laborables al año, un usuario promedio costaría 150 000 USD, mientras que los usuarios intensivos alcanzarían 1,75 millones de USD.
Anthropic es más directa: mide no el dinero, sino las horas trabajadas. Para agosto de 2026, las horas acumuladas de trabajo de los agentes bajo supervisión de empleados serán seis veces mayores que las de los humanos. La mayor parte de los tokens se usa para escribir software, logrando un aumento promedio de cinco veces en la velocidad de envío de código por ingeniero en seis meses.
Manus sigue una tendencia similar. Su cofundador Zhang Tao mencionó un mes en que el gasto medio en IA por persona superó los 10 000 USD, y algunos individuos gastaron entre 70 000 y 80 000 USD mensuales. No todo corresponde al costo de tokens, pero el mensaje es claro: ya no se trata solo de hacerle preguntas ocasionales a la IA, sino de gestionar simultáneamente un grupo de agentes.
Así, un billón de tokens puede verse como una cantidad grande o pequeña. Comparado con plataformas de IA, es solo una fracción; pero para una empresa de pagos, ese billón se concentra en unos 1400 desarrolladores, sin contar atención al cliente, cumplimiento normativo, control de riesgos ni IA orientada al cliente. Desde esta perspectiva, que Adyen se prepare para 100 billones de tokens anuales no es exagerado.
Los tokens se consumen, pero las cuentas aún deben liquidarse.
Un billón de tokens no equivale a una factura fija: los precios de distintos modelos pueden variar hasta cien veces. Según los precios estándar de la API de OpenAI anunciados el 28 de octubre de 2026, asumiendo que el 80 % de los tokens son entrada y el 20 % salida: si todos se usaran con GPT-6 Luna, el costo teórico sería de unos 180 000 USD; si todos fueran con GPT-6 Astra, sería de unos 18 millones de USD.
Adyen usa muchos modelos distintos y posee su propia infraestructura de razonamiento, enrutamiento semántico y precios empresariales, así que su factura real ciertamente no es tan simple como esa multiplicación. Un billón de tokens puede resultar muy barato o muy costoso. Gastar mucho no implica necesariamente usarlo bien.
Tras agotar los tokens, las empresas deben responder preguntas fundamentales: ¿cuánto código se completó sin incidencias? ¿Cuántos comerciantes normales fueron mal calificados? ¿Cuántos tickets de soporte se resolvieron sin derivarlos a agentes humanos? Al gestionar reclamaciones por cargos no autorizados, ¿se proporcionaron los documentos correctos a las personas adecuadas?
Hay una pregunta más importante que el costo: ¿hasta dónde puede llegar la IA? Ayudar al soporte al cliente a verificar información no es muy arriesgado; ayudar a los ingenieros a escribir código aún permite pruebas y revisiones; pero si los agentes pueden mover fondos, congelar cuentas o rechazar comerciantes directamente, el costo de los errores cambia radicalmente.
Al menos por ahora, las empresas de pagos no consultarán un modelo grande sobre cada pago. Una división de tareas más realista es: el libro contable sigue registrando transacciones, reglas y modelos especializados siguen evaluando operaciones, los modelos grandes se encargan de leer y escribir código, verificar información y manejar excepciones, mientras los humanos permanecen en funciones donde los errores tienen un costo mayor.
El dinero fluye como el agua, y los tokens también.
Fin del artículo
Este artículo se basa únicamente en observaciones y reflexiones personales y no constituye consejo financiero ni comercial. Se recomienda a los lectores considerar racionalmente su propia comprensión y sus fuentes de información.