Was macht die KI des Zahlungsunternehmens mit einer Billion Tokens pro Jahr?
 Tapbit Wire
Adyens CTO sagte, das Unternehmen habe etwa 1.400 Entwickler, die jährlich rund eine Billion Tokens verbrauchen. In den letzten drei Monaten hat sich diese Zahl vervierfacht; Adyen bereitet sich nun auf einen jährlichen Verbrauch von 100 Billionen Tokens vor.
Wofür werden die Tokens ausgegeben? Was genau wird damit gemacht?
Adyens eine Billion Tokens wird hauptsächlich vom Engineering-Team verbraucht. Bei anderen Zahlungsanbietern fließen Tokens auch in Händlerprüfungen, Kundenbetreuungsantworten, Bearbeitung von Chargebacks, E-Mail-Lesen und Untersuchung von Anomalien.
Geld fließt wie Wasser – und Tokens ebenso.
Menschen sitzen regungslos da, während Tokens weiterlaufen.
In den vergangenen 90 Tagen hat Adyens KI etwa eine Million Dokumente bearbeitet und an 20.000 Git-Commits teilgenommen. Die durchschnittliche Merge-Request-Zahl stieg um 48 %; Entwickler schätzen, dass KI ihnen etwa 15 % ihrer Zeit spart. Adyen geht davon aus, dass die Token-Ausgaben wahrscheinlich eine zweifache Rendite erzielt haben.
Sie nannten ein Beispiel: Adyen betreibt ein Backend-Zahlungssystem für Rechnungsstellung, Abstimmung und Kartengesellschaftsberichte mit rund 2.000 Produktionsaufgaben für über 40 Kartengesellschaften. Das ursprüngliche System war in einem großen Deployment-Image zusammengefasst; Adyen wollte es aufteilen, sodass jede Kartengesellschaft ihr eigenes unabhängiges Image erhält.
Nach früherer Praxis hätte dieses Projekt mehrere Teams und 6 bis 12 Monate benötigt. Stattdessen erledigten zwei Ingenieure es mithilfe von KI innerhalb von zwei Monaten ohne Zwischenfälle.
So verbraucht der Coding-Agent Tokens: Er füllt nicht nur ein paar Codezeilen aus, sondern liest zunächst den Code, die Dokumentation, identifiziert Abhängigkeiten und führt Tests aus. Bei Fehlschlägen analysiert er Fehlermeldungen, passt den Code an und führt Tests erneut aus. Öffnet eine Person mehrere Agenten gleichzeitig, wiederholen diese Prozesse sich kontinuierlich im Hintergrund. Menschen sitzen regungslos da, während Tokens weiterlaufen.
Auch Stripe berichtete, dass 91 % seiner Entwickler täglich KI nutzen (warum die restlichen 9 % noch nicht entlassen wurden, bleibt unklar). Der interne Coding-Agent reicht wöchentlich über 1.000 PRs in die Produktionsumgebung ein. Allein im März 2026 nutzten über 57.000 PRs KI-gestützte Codierung – ein Anstieg um 140 % binnen drei Monaten.
Ähnlich verhält es sich bei Block: Rund 7.500 Mitarbeitende nutzen wöchentlich KI; bei über 90 % aller Code-Commits ist KI beteiligt; die durchschnittliche wöchentliche Codeänderung stieg um 30 %.
Derzeit stammt ein Großteil der Token-Kosten bei Zahlungsanbietern aus der Engineering-Abteilung. KI im Zahlungssektor dient nicht nur dem Schreiben neuen Codes, sondern realistischerweise dem Bewältigen komplexer Herausforderungen. Zahlungssysteme sind riesig, enthalten viel Legacy-Code und müssen Banken, Kartengesellschaften sowie diverse Zahlungsmethoden integrieren. Diese Komplexität beanspruchte bisher vor allem Entwicklerzeit – nun wird zusätzlich KI eingesetzt, die Tokens verbraucht.
Dokumentensuche, Werbetexterstellung, Vertragslesevorgänge – alles verbraucht Tokens.
Code-Schreiben ist nur ein Teil der internen KI-Nutzung. Ein etwas größeres Fintech-Unternehmen verbringt täglich viel Zeit mit Informationsrecherche: Wo finde ich die Erstattungsrichtlinie? Welches Team verwaltet diese Daten? Wo beantrage ich Zugriffsrechte für ein bestimmtes System? Wen kontaktiere ich bei Urlaubsanträgen? Je größer das Unternehmen, desto mehr Dokumente gibt es – und desto leichter verliert man darin den Überblick.
Nubank beschäftigt rund 9.000 Mitarbeitende; verschiedene Teams speichern ihre Prozesse und Dokumente in Confluence. Bei Problemen suchen Beschäftigte oft eine halbe Stunde – und wenn sie nichts finden, erstellen sie ein Ticket und warten mehrere Stunden. Nubank entwickelte daraufhin das interne Tool „AskNu“, über das Mitarbeitende direkt in Slack Fragen stellen können. AskNu identifiziert zunächst die zuständige Abteilung, sucht dann in den entsprechenden Confluence-Dokumenten nach Antworten und generiert schließlich mithilfe eines Large Language Models eine strukturierte Antwort mit Original-Link.
Sechs Monate nach dem Start hatte AskNu 5.000 Nutzer und verarbeitete 280.000 Nachrichten. Nubank gab an, interne Tickets um 96 % reduziert zu haben. Probleme, die zuvor 30 Minuten zur Lösung brauchten oder ein achtstündiges Warten auf ein Ticket erforderten, werden nun im Durchschnitt nach 9 Sekunden beantwortet.
AskNu unterstützt Kunden nicht direkt beim Geldtransfer oder bei Zahlungsabwicklungen, sondern liest kontinuierlich Fragen, ruft Dokumente ab und strukturiert Antworten. Jeder Mitarbeiter stellt täglich einige Fragen, wodurch sich Tokens schrittweise ansammeln.
Das Content-Team arbeitet genauso. Chime benannte sein internes Content-Modell sehr direkt: ChimeGPT. Zudem erstellte es ein „Markenhirn“, das frühere Markengeschichten, Nutzerfeedback, Kampagnenergebnisse und Community-Diskussionen enthält. Das Marketingteam nutzt es, um verschiedene Content-Versionen und personalisierte Onboarding-Prozesse zu generieren, die anschließend von Brand-, Rechts- und Compliance-Teams geprüft werden.
Chime enthüllte, dass die interne Content-Produktion im Jahresvergleich um über 300 % gestiegen ist und die Produktionszeit um 60 % gesunken ist. Was früher zehn Stunden von der Idee bis zur Kampagne dauerte, lässt sich heute in rund vier Stunden abschließen; zudem hat sich das Testvolumen verdreifacht. Auch Klarnas Organisationsdaten sind bemerkenswert: 90 % der Mitarbeitenden nutzen generative KI täglich; in den Bereichen Kommunikation, Marketing und Recht liegt die Nutzung bei 93 %, 88 % bzw. 86 %.
Code schreiben verbraucht Tokens – ebenso Werbeanzeigen verfassen, Materialien übersetzen, Meetings zusammenfassen, Verträge lesen oder Kollegenfragen beantworten.
Ein ‚champagnerfarbenes Kleid‘ bedeutet nicht, Alkohol zu verkaufen.
Zahlungsunternehmen führen täglich eine Aufgabe aus, die der Identitätsprüfung ähnelt: Wer ist diese Person? Was verkauft sie genau? Dürfen wir sie hereinlassen und Geld für sie einsammeln?
Händler stellen sich selbstverständlich nicht ehrlich gemäß den Formularen des Zahlungsunternehmens vor. Hinweise sind über offizielle Webseiten, Produktseiten, Registrierungsdokumente und Zeitungsartikel verstreut – möglicherweise in verschiedenen Sprachen. Frühere Systeme waren für solche Komplexität nicht geduldig; die einfachste Methode war die Schlüsselwortprüfung.
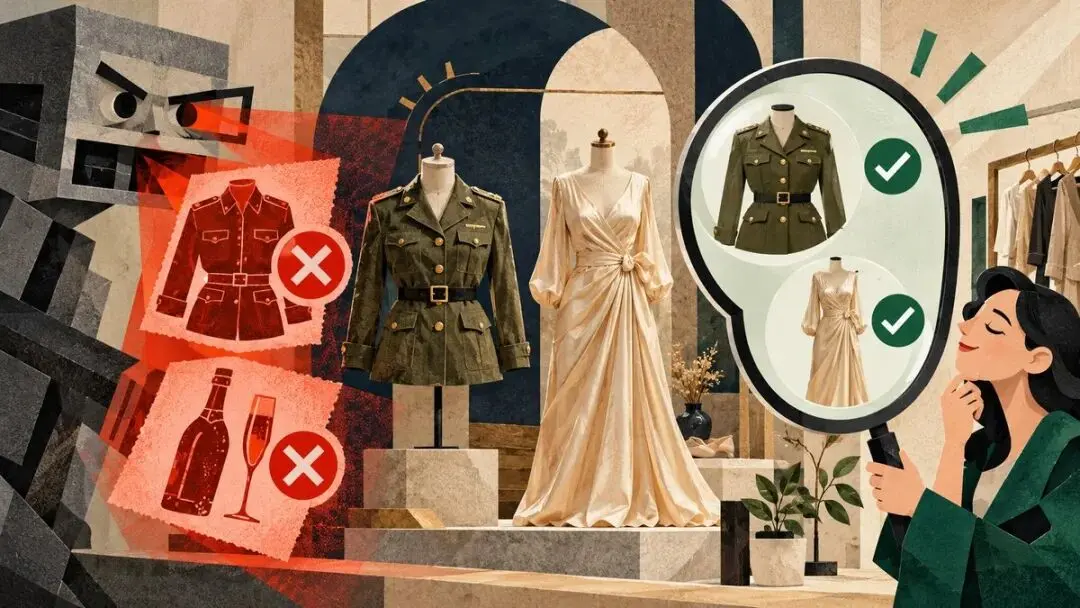
Airwallex lieferte ein humorvolles Beispiel: Ein Händler verkauft eine „militärische Jacke“, und das System erkennt „militärisch“ – was den Verdacht wecken könnte, er verkaufe verbotene Militärgüter; ein anderer Händler beschreibt ein „champagnerfarbenes Kleid“, und das System sieht „Champagner“, was den Verdacht auf Alkoholverkauf nahelegt.
Ein Mensch erkennt auf einen Blick, dass eine militärische Jacke keine Waffe ist und dass in einem champagnerfarbenen Kleid kein Champagner steckt. Schlüsselwörter verstehen jedoch weder Farben noch Mode – sie wissen nur, dass dieses Wort etwas gefährlich wirkt.
Genau darin überzeugen große Modelle: Sie konzentrieren sich nicht nur auf ein einzelnes Wort, sondern lesen zunächst den Kontext und erkennen dann, was der Händler tatsächlich verkauft. Airwallex berichtete, dass nach der Integration generativer KI in KYC die durchschnittliche Rate falsch positiver Ergebnisse um 50 % sank und die Zahl der Kunden, die ohne menschliches Eingreifen onboardingfähig wurden, um 20 % stieg.
Stripe begann 2023 ebenfalls mit LLMs für das Händler-Onboarding. Das große Modell darf nicht alle Händler freigeben; stattdessen verarbeitet es zunächst offene, unstrukturierte Informationen und leitet Anträge, die eindeutig den Anforderungen entsprechen, schnell weiter. Über 80 % der „qualifizierten Händler“ können sofort automatisch freigegeben werden. Bei Checkout.com sank die Prüfzeit für Richtlinien von 60 auf 10 Minuten.
Früher mussten Mitarbeitende Webseiten öffnen, Unterlagen lesen, Richtlinien prüfen und selbst Schlussfolgerungen formulieren; heute liest das große Modell zuerst alles durch und markiert Bereiche, die menschliche Aufmerksamkeit benötigen. Die hier verbrauchten Tokens sparen falsch positive Ergebnisse, beschleunigen Kontoeinrichtungen und reduzieren den Zeitaufwand interner Mitarbeitender für unproblematische Unterlagen.
Selbst ein fünf-Dollar-Kaffee muss die Finanzabteilung durchlaufen.
Zahlungsunternehmen helfen anderen beim Geldumgang, intern müssen sie aber dennoch Erstattungen bearbeiten, Ausgaben prüfen, Rechnungen einfordern und Buchhaltung betreiben. Dies ist wahrscheinlich die unauffälligste Art von Fintech-KI-Produkten. Wenn ein Mitarbeiter mit einer Firmenkarte einen Kaffee kauft, muss er möglicherweise einen Beleg hochladen, den Verwendungszweck angeben und eine Ausgabenkategorie wählen; Führungskräfte müssen bestätigen, ob es geschäftlich war, die Finanzabteilung prüft die Richtlinien, führt die Buchhaltungskodierung durch und synchronisiert sie mit dem ERP. Der Betrag mag nur fünf Dollar betragen – doch die Bearbeitungskosten sind oft höher.
Ramp entwickelte einen speziellen Policy Agent zur Prüfung solcher Ausgaben. Er prüft, ob Beleg und Transaktion übereinstimmen, ob doppelte Erstattungen vorliegen, ob der Verwendungszweck klar angegeben ist, ob die Richtlinien verletzt werden und ob der Mitarbeiter kürzlich ungewöhnliche Ausgaben tätigte. Konforme Ausgaben können automatisch zur Genehmigung vorgeschlagen werden, problematische hingegen werden an Menschen weitergeleitet. Ramp berichtet, dass frühe Kunden manuelle Prüfungen um ca. 85 % reduzierten und bei der Durchsetzung der Ausgabenrichtlinien eine Genauigkeit von über 99 % erreichten – die endgültige Genehmigung bleibt jedoch beim Prüfer.
Der Brex Assistant übernimmt noch banalere Aufgaben: Er findet automatisch Belege, verfasst Notizen, füllt Ausgabenkategorien und Teilnehmer aus und hinterfragt Mitarbeitende proaktiv bei nicht konformen Ausgaben. Brex nannte ein Beispiel: Ein Beleg enthält zwar nicht das Wort „Alkohol“, sondern nur „Wodka“. Frühere Schlüsselwortregeln hätten das möglicherweise übersehen – doch das große Modell weiß, dass Wodka als Alkohol gilt.
Solche Aufgaben eignen sich gut dafür, Tokens gegen Zeit einzutauschen.
AML-Analyst:innen verbringen den größten Teil ihrer Zeit nicht damit, Kriminelle zu entlarven.
Zahlungsunternehmen generieren täglich eine große Zahl Risiko-Alarme. Nur wenige Transaktionen sind tatsächlich verdächtig, doch jeder Alarm erfordert, dass jemand ihn öffnet, Kundeninformationen prüft, historische Transaktionen begutachtet, verwandte Konten untersucht und schließlich einen Absatz verfasst, der begründet, warum der Fall geschlossen oder weiterverfolgt wird. Viele AML-Analyst:innen verbringen ihre Zeit nicht mit der Jagd auf Kriminelle, sondern damit, nachzuweisen, dass eine Person momentan nicht wie eine Verdächtige aussieht.
Nexo nutzt den KI-Agenten von Unit21 für erste Alarmprüfungen. Der Agent strukturiert Transaktions- und Kontoinformationen, analysiert Beziehungen zwischen Adressen und erstellt Untersuchungszusammenfassungen sowie Handlungsempfehlungen. Analyst:innen beginnen nicht mehr bei Null, sondern prüfen lediglich die vom KI-Agenten bereitgestellten Unterlagen und Schlussfolgerungen.
In der von Unit21 und Nexo veröffentlichten Fallstudie heißt es, dass Nexos Falsch-Positiv-Rate im Vergleich zum vorherigen internen System um 93 % gesunken ist; aktuell werden 57 % der Alarmprüfungen vollautomatisch durch KI abgewickelt – Ziel ist ein Anteil von 80 %. Dieser Zahlenblock ist zu beachten: Er stammt aus einer gemeinsamen Veröffentlichung von Anbieter und Kunde, nicht aus einer unabhängigen Prüfung; Unit21 hat nicht offengelegt, wie viele Tokens pro Untersuchung verbraucht werden.
Dieser Fall verdeutlicht jedoch klar, was KI im AML-Bereich leisten kann: Die Maschine sammelt die Unterlagen, kartiert Beziehungen und verfasst den Bericht; Menschen entscheiden dann, ob ein Fall tatsächlich verdächtig ist und ob er den Aufsichtsbehörden gemeldet werden muss.
Ein Kunde fragte einfach: „Wo ist mein Geld?“
Der Kundenservice bei Zahlungsunternehmen ist manchmal nicht so einfach wie „Helfen Sie mir, mein Passwort zu ändern.“ Wenn ein Kunde fragt: „Warum ist das Geld noch nicht eingegangen?“, kann dies Akquirierbank, Kartennetzwerk, Ausstellbank, Währungsumtausch, Abrechnungszyklus, Rückerstattungsstatus und Kontobeschränkungen betreffen. Kundenservicemitarbeiter:innen müssen mehrere Systeme abfragen und die Informationen zu einer kohärenten Antwort zusammensetzen.
KI-Agenten durchlaufen denselben Prozess: erst das Problem verstehen, dann die Transaktion abfragen, Regeln abrufen, den nächsten Schritt bestimmen und schließlich eine Antwort generieren. Bei jeder Systemabfrage müssen die Ergebnisse an das Modell zurückgesendet werden – Tokens werden wiederholt verbraucht.
Checkout.com gibt an, dass etwa 60 % der Kundenservice-Anfragen einfache, sich wiederholende Fragen sind; bis 2026 soll der Anteil der vom KI-Agenten eigenständig bearbeiteten Anfragen über 50 % liegen. Block enthüllte, dass bei Cash App bereits rund 65 % der Kundenservice-Fälle KI nutzen. Klarna nennt konkretere Zahlen: Sein KI-Assistent unterstützte im ersten Halbjahr 2024 über 4 Millionen Kunden; jährliche Einsparungen werden auf 40 Mio. USD geschätzt.
Die Berechnung der für Kundenservice verbrauchten Tokens ist einfach: Früher bearbeitete eine bestimmte Zahl Mitarbeiter:innen eine bestimmte Zahl Tickets; heute bearbeitet eine bestimmte Token-Menge dieselbe Ticketanzahl – zählbar ist, ob ein Transfer an menschliche Agent:innen erfolgte oder ob der Kunde den Fall erneut öffnete.
Dasselbe gilt für Chargebacks und Streitfälle. Stripe erhält zahlreiche automatisierte E-Mails von Finanzpartnern, die früher einzeln gelesen und manuell im System verarbeitet werden mussten; heute lesen LLMs diese E-Mails, verstehen die Anforderung des Partners und wandeln sie in API-Aufrufe um. Checkout.com berichtet zudem, dass die Verteilung abgelehnter Transaktionen – früher manuell ausgeführt – nun zu 100 % automatisiert ist.
Diese Aufgaben mögen nicht so bahnbrechend klingen wie „KI verändert die Finanzwelt“, sind aber zeitaufwendig und ideal für Token-Verbrauch.
Wenn KI beginnt, während sie Ihre Bestände betrachtet, zu sprechen
Die bisher genannten KIs sind meist unsichtbar für Kunden: Sie arbeiten im Hintergrund in Code, Audits und Kundenservice-Systemen. Robinhood Cortex ist anders: Er erscheint direkt auf den Smartphones der Anleger:innen.
Wenn ein Nutzer einen Wertpapierhandel öffnet, liest Cortex Echtzeitkurse, aktuelle Nachrichten, Analystenberichte, technische Kennzahlen und eigene Robinhood-Daten und erklärt in verständlicher Sprache, warum der Kurs heute steigt oder fällt. Zudem verknüpft er die Erklärung mit den individuellen Beständen des Nutzers und zeigt, warum diese Nachricht für dessen Konto relevant ist.
Robinhood enthüllte, dass Cortex Digests bis zum ersten Quartal 2026 von fast einer Million Kunden genutzt wurden. Als nächster Schritt soll es Nutzer:innen ermöglichen, Aktien und Kryptowährungen zu kaufen und zu verkaufen, Marktanalysen durchzuführen und Kontoeinstellungen per natürlicher Sprache anzupassen.
Ab diesem Punkt verbrauchen nicht nur Unternehmensmitarbeiter:innen Tokens: Jede Nutzerfrage führt dazu, dass Cortex eine Nachricht oder einen Research-Bericht liest; bei jeder Neubewertung anhand persönlicher Bestände muss der Kontext erneut verarbeitet werden.
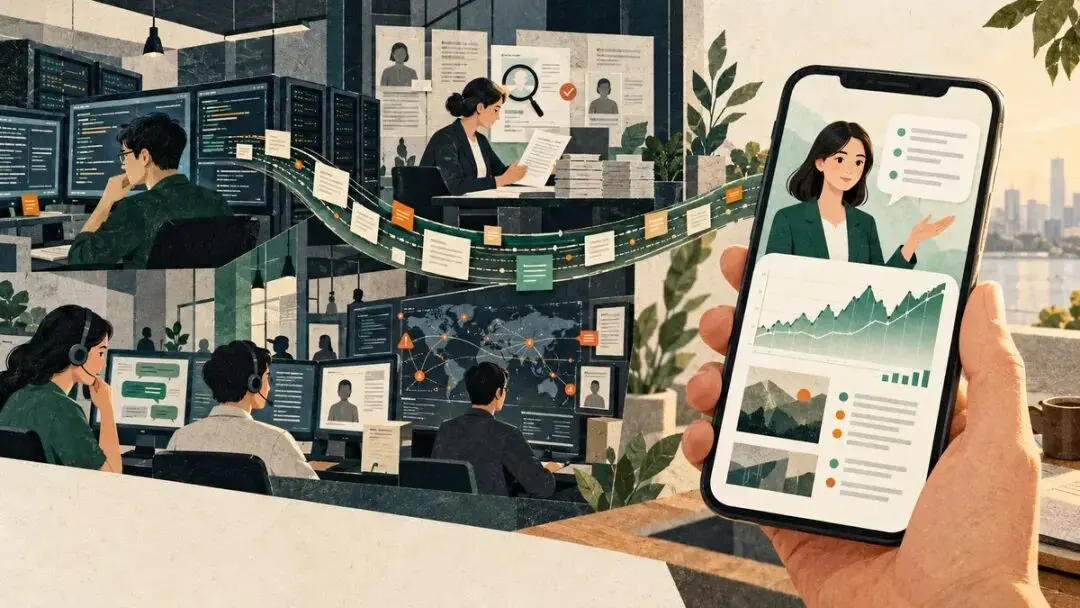
Die eigentliche Herausforderung ist, dass sich bei KI-Handlungen im Namen der Nutzer:innen die Kosten von Fehlern ändern: Ist eine Nachricht falsch dargestellt, wird der Nutzer möglicherweise nur irreführt; wird ein Wertpapier falsch gekauft, entstehen echte finanzielle Verluste. Daher hat Robinhood für Cortex klare Grenzen festgelegt: Was es sehen darf, was es sagen darf und welche Aktionen zwingend durch den Nutzer bestätigt werden müssen.
Eine Billion Tokens – was bedeutet das für KI-Unternehmen?
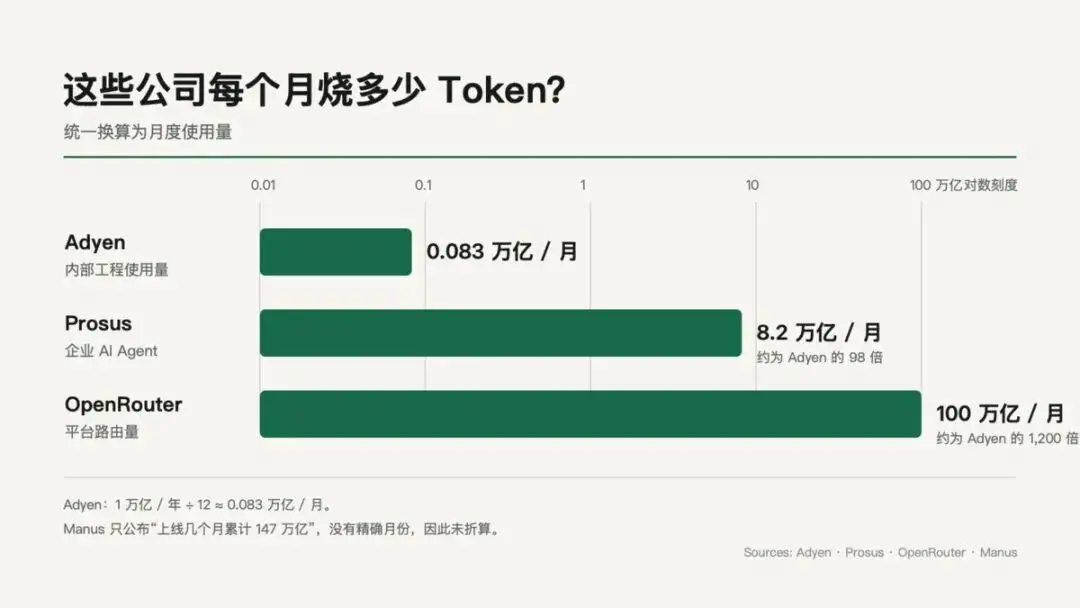
Zunächst betrachten wir Adyen selbst: Rund 1.400 Entwickler nutzen jährlich etwa eine Billion Tokens – im Durchschnitt 710 Millionen pro Person. Bei 250 Arbeitstagen sind das rund 2,86 Millionen Tokens pro Person und Tag. Damit ist die KI längst nicht mehr nur gelegentlich beim Ausfüllen einiger Codezeilen behilflich; vielmehr arbeitet ein KI-Agent den ganzen Tag lang.
Doch sobald diese Zahl in den Kontext der gesamten KI-Branche gestellt wird, ändert sich die Maßeinheit rasch.
Manus‘ Produkt ist seit wenigen Monaten online und hat bereits über 147 Billionen Tokens verarbeitet – das entspricht Adyens jährlichem Verbrauch über 147 Jahre. OpenRouter leitet mittlerweile monatlich 100 Billionen Tokens weiter, was dem jährlichen Verbrauch von 100 Adyen-Unternehmen pro Monat entspricht. Zwar handelt es sich hier um Plattformen mit zahlreichen Kunden und nicht um ein internes Engineering-Team eines Unternehmens, doch die Größenordnung des Unterschieds ist deutlich erkennbar.
Betrachten wir ein Unternehmen wie Prosus, das typische E-Commerce- und Internetgeschäfte betreibt: Dort unterstützen KI-Agenten 40.000 Mitarbeiter, 5 Millionen Partner und 1 Milliarde Nutzer. Der monatliche Tokenverbrauch liegt bei 82 Billionen – Adyens jährlicher Verbrauch wird damit alle vier Tage erreicht. Innerhalb des vergangenen Jahres stieg der Tokenverbrauch um das 52-Fache.
OpenAI hat nicht offengelegt, wie viele Tokens es jährlich selbst verbraucht, aber die Forscherausgaben wurden bekanntgegeben: Bis August 2026 wird die mediane tägliche Rechenkosten eines Forschers – basierend auf den API-Preisen – 600 US-Dollar überschreiten; die obersten 10 % geben täglich über 7.000 US-Dollar aus. Bei 250 Arbeitstagen pro Jahr belaufen sich die Kosten für eine Person auf 150.000 US-Dollar, für starke Nutzer auf bis zu 1,75 Millionen US-Dollar.
Anthropic geht noch direkter vor: Statt Geld misst es Arbeitsstunden. Bis August 2026 werden die gesamten Arbeitsstunden der unter Mitarbeitern eingesetzten Agenten das Sechsfache der menschlichen Arbeitsstunden betragen. Der Großteil der Tokens fließt in die Softwareentwicklung – die durchschnittliche Geschwindigkeit der Code-Einreichung pro Entwickler steigt innerhalb von sechs Monaten um das Fünffache.
Ähnlich verhält es sich bei Manus: Mitgründer Zhang Tao erwähnte einen Monat, in dem die durchschnittlichen KI-Ausgaben pro Person über 10.000 US-Dollar lagen – einige Einzelpersonen gaben sogar 70.000 bis 80.000 US-Dollar monatlich aus. Nicht alle davon entfallen auf Token-Kosten, doch die Aussage ist klar: Man stellt der KI nicht mehr nur gelegentlich Fragen, sondern einzelne Personen managen nun gleichzeitig mehrere Agenten.
Eine Billion Tokens erscheint daher sowohl groß als auch klein: Im Vergleich zu KI-Plattformen ist sie nur ein Bruchteil; für ein Zahlungsunternehmen jedoch erfolgt dieser Verbrauch allein unter rund 1.400 Entwicklern – ohne Kundenservice, Compliance, Risikosteuerung oder kundenorientierte KI. Vor diesem Hintergrund ist Adyens Ziel von 100 Billionen Tokens pro Jahr keineswegs übertrieben.
Tokens können verbraucht werden – doch die Rechnungen müssen trotzdem beglichen werden.
Eine Billion Tokens entspricht keiner festen Rechnungssumme; die Preise verschiedener Modelle können sich um den Faktor 100 unterscheiden. Gemäß den am 28. Oktober 2026 von OpenAI veröffentlichten Standard-API-Preisen – unter der Annahme, dass 80 % der Tokens als Eingabe und 20 % als Ausgabe genutzt werden – läge die theoretische Kosten bei ausschließlicher Nutzung von GPT-6 Luna bei rund 180.000 US-Dollar, bei ausschließlicher Nutzung von GPT-6 Astra bei etwa 18 Millionen US-Dollar.
Adyen nutzt tatsächlich zahlreiche verschiedene Modelle und verfügt über eigene Reasoning-Infrastruktur, semantisches Routing sowie Enterprise-Preismodelle – die tatsächliche Rechnung ist daher weitaus komplexer als diese einfache Multiplikation. Eine Billion Tokens kann sehr günstig oder sehr teuer sein; hohe Ausgaben bedeuten nicht zwangsläufig effiziente Nutzung.
Nach Verbrauch der Tokens müssen Unternehmen grundlegende Fragen beantworten: Wie viel Code wurde fehlerfrei fertiggestellt? Wie viele reguläre Händler wurden fälschlich abgelehnt? Wie viele Kundenservice-Tickets wurden vollständig gelöst, ohne an Menschen zurücküberwiesen werden zu müssen? Wurden bei Chargebacks die richtigen Unterlagen an die zuständigen Personen bereitgestellt?
Eine Frage ist wichtiger als die Kosten: Wie weit darf KI gehen? Kundenservice bei der Informationsabfrage zu unterstützen, birgt kaum Risiko; Entwicklern beim Codieren zu helfen, bleibt durch Tests und Reviews kontrollierbar; doch wenn Agenten direkt Geld bewegen, Konten sperren oder Händler ablehnen dürfen, ändert sich die Fehlerkosten fundamental.
Zumindest aktuell fragt kein Zahlungsunternehmen bei jeder Transaktion ein Großmodell ab. Eine realistischere Aufteilung sieht so aus: Das Hauptbuch führt weiterhin die Buchhaltung, Regeln und spezialisierte Modelle prüfen weiterhin Transaktionen, Großmodelle lesen und schreiben Code, überprüfen Informationen und bearbeiten Ausnahmen – während Menschen dort verbleiben, wo Fehler besonders kostspielig wären.
Geld fließt wie Wasser – und Tokens ebenso.
Ende des Artikels
Dieser Artikel basiert ausschließlich auf persönlichen Beobachtungen und Überlegungen und stellt keine Anlage- oder Geschäftsberatung dar. Leserinnen und Leser werden ermutigt, ihre Entscheidungen sachlich und unter Berücksichtigung eigener Erkenntnisse sowie Informationsquellen zu treffen.