Der Aufstieg riesiger Plattformen und mikrosoftwarebasierter Unternehmen birgt eine gefährliche Situation für mittelgroße Einzelpunkt-Lösungen
 Tapbit Wire
Originalzusammenstellung: Deep Tide TechFlow
Deep Tide-Leitfaden: 537 US-Unicorns halten noch die alten Bewertungen aus der Blasenphase 2021; das Label „KI-native“ wandelt sich vom Bonus zum Risikofaktor. Für Praktiker, die aktuell Kapital beschaffen oder Optionen halten, hilft dieser Artikel, echte Bewertungen von bloßen, unbestätigten Papierzahlen zu unterscheiden.
537 US-Unicorns halten noch Bewertungen aus der Blasenphase 2021–22. Sind sie noch real?
Gründer und frühe Mitarbeiter lernen oft, die Bewertung der letzten Runde als Scoreboard zu betrachten – jene Zahl in der Kapitalstruktur, in Pressemitteilungen und zur Schätzung des Eigenkapitalwerts.
Neue Daten aus PitchBooks quantitativem Ausblick Q3 2026 zeigen jedoch, dass diese Zahl für die meisten US-Unicorns seit mehreren Jahren nicht wirklich marktgetestet wurde.
PitchBook analysierte alle aktiven US-Unicorns nach dem Jahr ihrer zuletzt bewerteten Finanzierungsrunde.
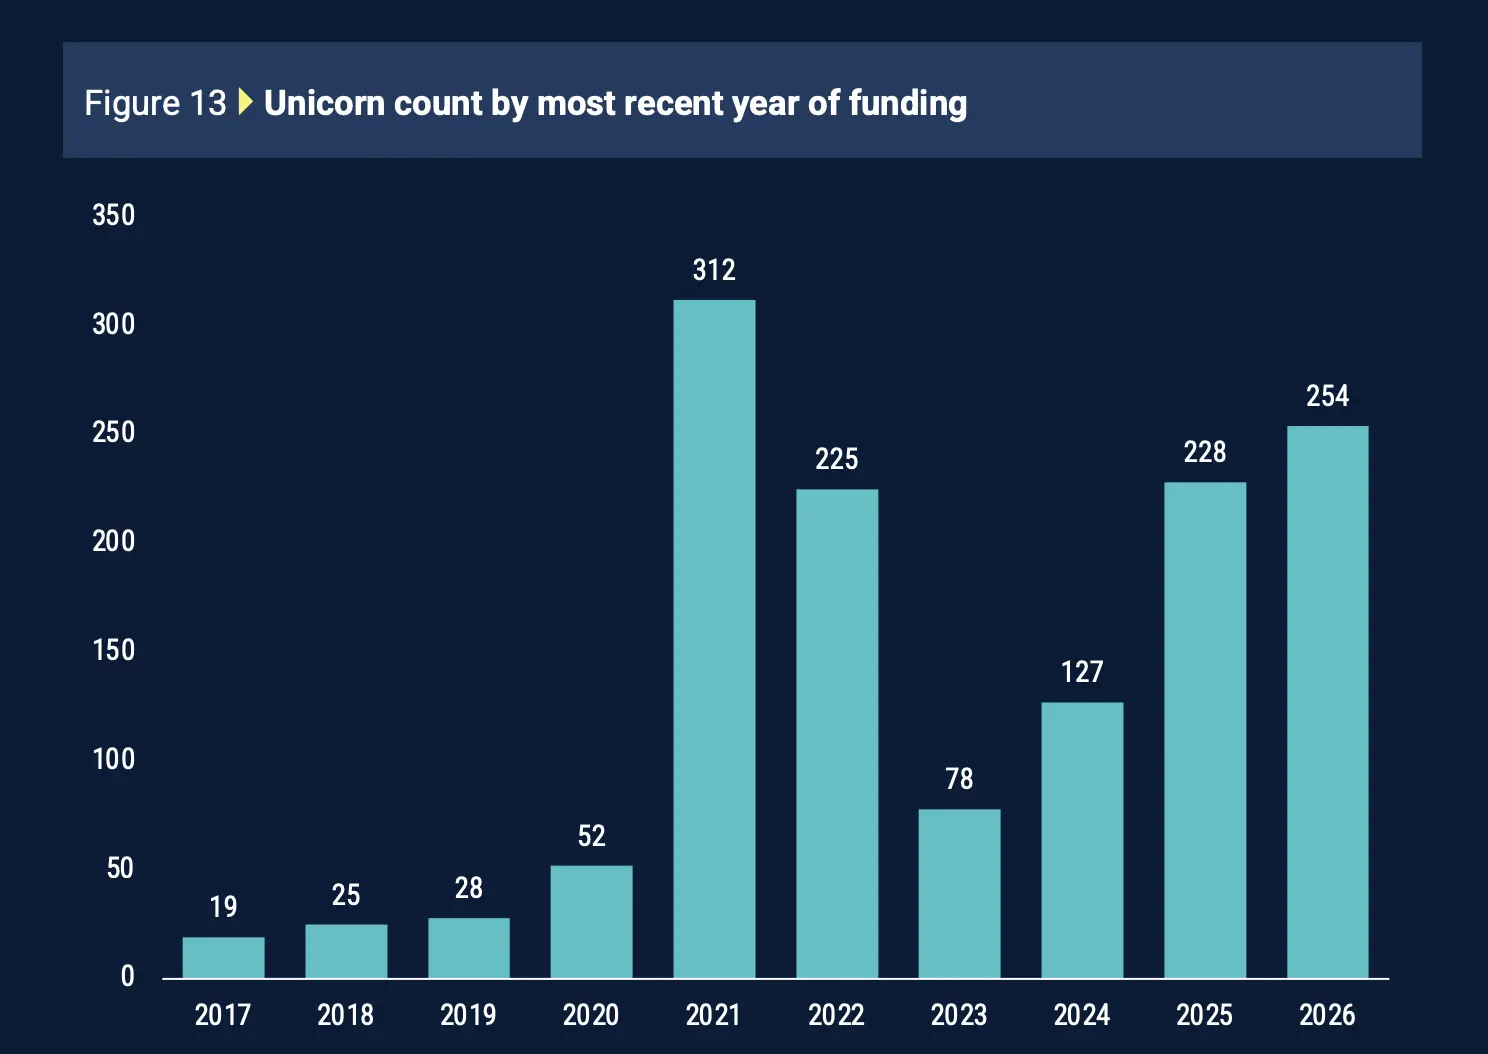
Unter den 964 aktiven US-Unicorns haben 312 zuletzt 2021 und weitere 225 2022 Kapital beschafft. Damit tragen 537 Unternehmen (ca. 56 % aller Unicorns) noch Bewertungen aus der teuersten Finanzierungsphase der VC-Geschichte.
Geld kehrt nicht mehr zurück, um diese Zahlen zu rechtfertigen. Der Anteil von Risikokapital an dem gesamten Anlagevermögen liegt bei nur 7,9 % – knapp halb so viel wie der langfristige Durchschnitt von 14,5 %. PitchBook weist darauf hin, dass die Fondsrenditen direkt durch die überhöhten Bewertungen von 2020 bis 2022 gedrückt wurden.
Bei tatsächlichen Preisprüfungen halten viele Unternehmen diese Werte nicht mehr. Börseninvestoren lehnen private Marktpreise ab. Chimes Bewertung beim Börsengang sank deutlich unter ihren privaten Höchstwert; Käufer im Sekundärmarkt gewähren deutlich höhere Abschläge für Unternehmen, deren letzte Finanzierungsrunde Jahre zurückliegt – im Vergleich zu frisch finanzierten Firmen.
Hinter diesem Trend steht ein zweiter: Viele dieser Unternehmen stagnieren nicht aus Unfähigkeit, sondern verzichten bewusst auf neue Finanzierungsrunden oder einen Börsengang – denn jede neue Bewertung könnte sie mit einer niedrigeren Zahl konfrontieren. Als privat bleibende, stille Firmen bleibt die Bewertung von 2021 weiterhin „auf dem Papier“. Daher können gleichzeitig Rekord-Papierwerte und Rekord-„eingefrorene“ Werte bestehen.
Ist also der Unicorn-Boom real – oder nur eine unbestätigte Zahl?
Für viele Unternehmen trifft beides zu: Manche sind tatsächlich so gereift, dass sie ihre Bewertung von 2021 heute problemlos halten können. Doch der Markt kann nicht identifizieren, welche Unternehmen dazu gehören – da sie seitdem weder Kapital beschafft noch zu realen Preisen verkauft haben. Eine vier Jahre alte Bewertung ist keine Lüge – sie ist einfach unbestätigt.
Genau hier müssen Gründer und Mitarbeiter vorsichtig sein.
Falls Ihre Firma zuletzt 2021 oder 2022 finanziert wurde, ist die Bewertung in der Kapitalstruktur die optimistischste Zahl, die Sie je besaßen – doch sie entspricht nicht zwangsläufig dem heutigen tatsächlichen Wert. Das beeinflusst Verhandlungen über die nächste Runde, die Entscheidung zum Ausübungszeitpunkt von Optionen und die Erklärung ihres Wertes gegenüber dem Team. Gleiches gilt für Investoren: Zeigt ein Fonds starke unrealisierte Gewinne bei diesen Unternehmen an, handelt es sich lediglich um Papierzahlen – nicht um echtes Bargeld.
Das eigentliche Risiko liegt nicht darin, dass die Bewertung niedriger sein könnte als vermutet, sondern darin, bei Finanzierungs-, Einstellungs- oder Optionsausübungsentscheidungen die 2021 festgelegte Zahl als aktuellen Marktpreis zu behandeln.
Bezeichnet man Startups als „KI-native“, könnte das sogar die Bewertung schädigen?
Sich als KI-Unternehmen zu positionieren, kann nach wie vor eine Bewertungsprämie bringen. Doch Investoren stellen zunehmend eine zweite Frage: Wie viel davon ist tatsächlich durch KI geschützt?
Die Daten dieser Analyse zeigen, dass der Markt Unternehmen mit derselben Bezeichnung „KI-native“ bereits in völlig unterschiedliche Kategorien einteilt.
Die KI-Prämie existiert weiterhin: Daten von Carta für die erste Hälfte 2026 zeigen, dass KI-Startups bei Seed-Runden ähnlich viel Kapital einsammeln wie Nicht-KI-Unternehmen, ihre Bewertungen jedoch rund 50 % höher liegen.
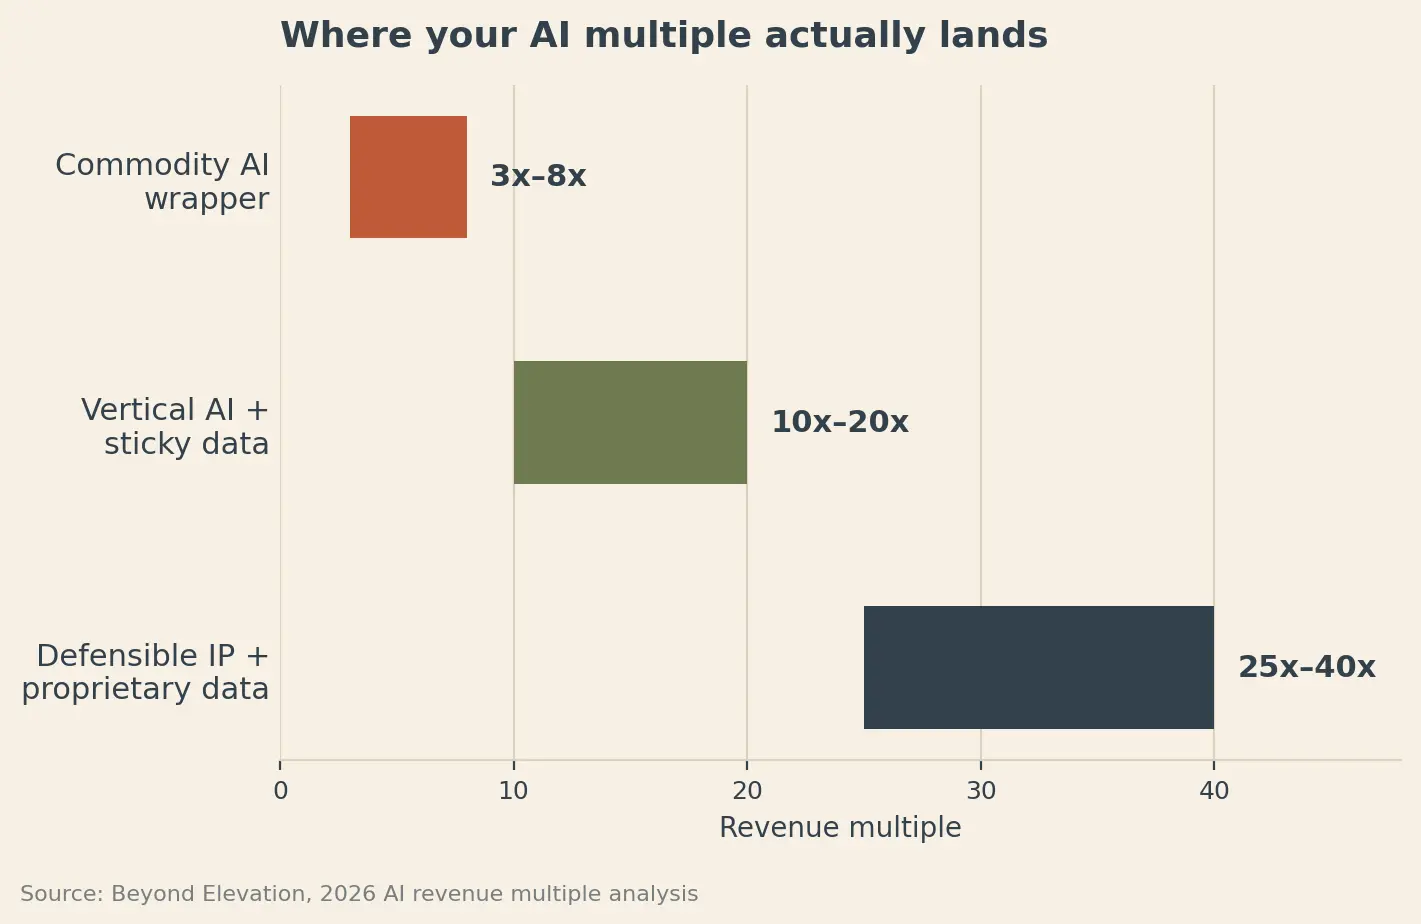
Doch nicht jedes KI-Unternehmen erhält dieselbe Prämie: Analysen ordnen standardisierte KI-„Hüllenfirmen“ einer Bewertung von 3–8× Umsatz zu, vertikale KI-Produkte mit eigenem, bindendem Datenbestand 10–20× und Unternehmen mit echtem geistigem Eigentum und proprietären Daten 25–40×.
Je reifer das Unternehmen, desto strenger die Prüfung: Bei Seed-Runden erhalten Firmen ohne schützenswertes geistiges Eigentum einen Abschlag von 20–30 % gegenüber besser geschützten Konkurrenten; bei Series A vergrößert sich diese Lücke auf 30–40 %.
Daher wird es immer bedeutungsloser, einfach nur KI in ein Produkt einzubauen.
Investoren wollen zunehmend wissen, was bleibt, wenn man das KI-Etikett entfernt.
Kann ein anderes Startup dasselbe Produkt erstellen, indem es dieselbe Basis-Modell-API aufruft? Generiert jeder neue Kunde proprietäre Daten, die das Produkt messbar verbessern – etwa Genauigkeit, Bearbeitungszeit oder Matching-Qualität? Ist die Software tief genug in den Workflow eingebettet, sodass ein Austausch schmerzhaft wäre? Hält das unit-economical Modell auch bei zehnfach gestiegener Inferenzmenge?
Diese Fragen weisen auf vier Bereiche hin, die Gründer vor der nächsten Finanzierungsrunde prüfen sollten: technologische Differenzierung, proprietäre Daten, Workflow-Bindung und unit-economical Modelle im Skalierungsfall.
Der eigentliche Test für technologische Differenzierung ist überraschend einfach: Tauschen Sie das zugrundeliegende Modell aus. Führt ein Wechsel zum Hauptmodell-Anbieter gegen ein vergleichbares Modell zu kaum merklichen Produktänderungen, sehen Investoren möglicherweise keine technologische Schutzzone.
Bei proprietären Daten reicht allein die Nutzerzahl nicht aus. Ein stärkeres Signal ist, ob steigende Nutzung Daten generiert, die das Produkt messbar verbessern – etwa Genauigkeit, Bearbeitungszeit oder Matching-Qualität.
Die Tiefe der Workflow-Integration ist ein weiterer Hinweis. Wenn Kunden mit tieferer Integration konsequent bessere Retention und Expansion zeigen, haben Gründer greifbare Belege für Wechselkosten – statt lediglich starke Produkthaftung zu behaupten.
Dann bleibt das wirtschaftliche Modell: Ein KI-Produkt mag bei aktuellem Nutzungsgrad gute Margen erzielen – doch das könnte sich bei zehnfach gestiegener Inferenzmenge komplett ändern. Diese Berechnungen vorab zu klären, offenbart, ob das Geschäft beim Wachsen tatsächlich robuster wird.
Damit wird die Entwicklung der „KI-native“-Prämie besonders spannend.
Vor achtzehn Monaten konnte allein die Assoziation mit KI die Finanzierungserzählung deutlich stärken. Je mehr Startups dieselbe Rhetorik nutzen, desto stärker suchen Investoren nach dem, was dahintersteckt.
Das KI-Etikett öffnet die Tür zum Gespräch. Der immer wertvollere Teil ist der Nachweis, warum Ihr Aufbau mit zunehmender Größe schwerer kopierbar wird.
Der Barbell-Effekt der Software: KI wird die mittlere Schicht des Softwaremarktes bald eliminieren.
KI macht Softwareentwicklung deutlich günstiger und schneller. Das klingt gut für Startups – könnte aber auch einige der Schutzzonen schwächen, die Softwareunternehmen jahrzehntelang gesichert haben.
Mike Vernal von Conviction zog einen interessanten Vergleich: Software könnte sich einer ähnlichen „Hantel“-Struktur annähern, die nach dem Aufkommen des Internets in der Zeitungsbranche entstand.
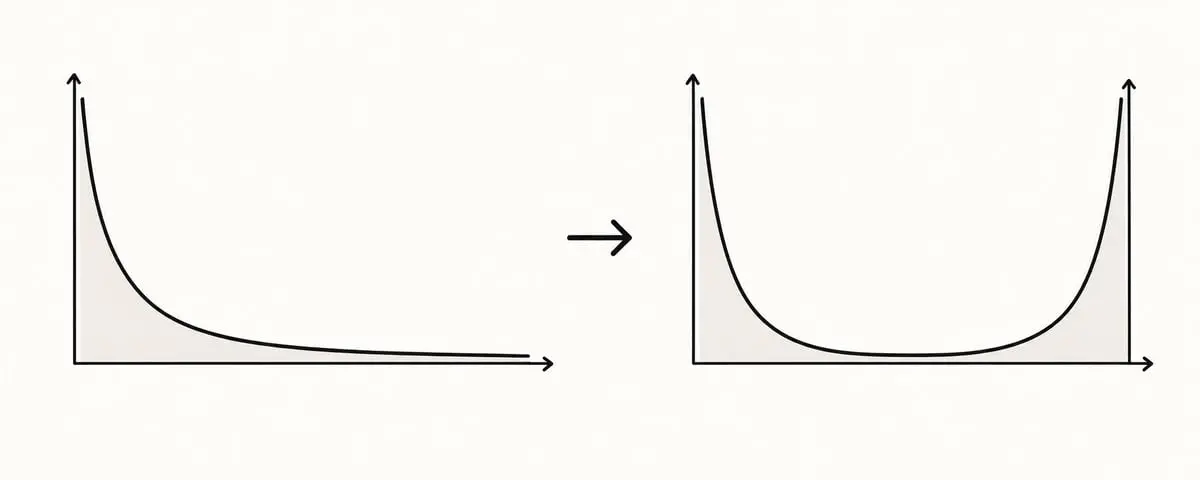
Vor dem Internet profitierten regionale Zeitungen von hohen Distributionskosten. Sobald die Distribution nahezu kostenlos wurde, verschwand der größte Teil der mittleren Schicht. Einige globale Publikationen wuchsen stark, während Tausende unabhängiger und spezialisierter Publikationen entstanden.
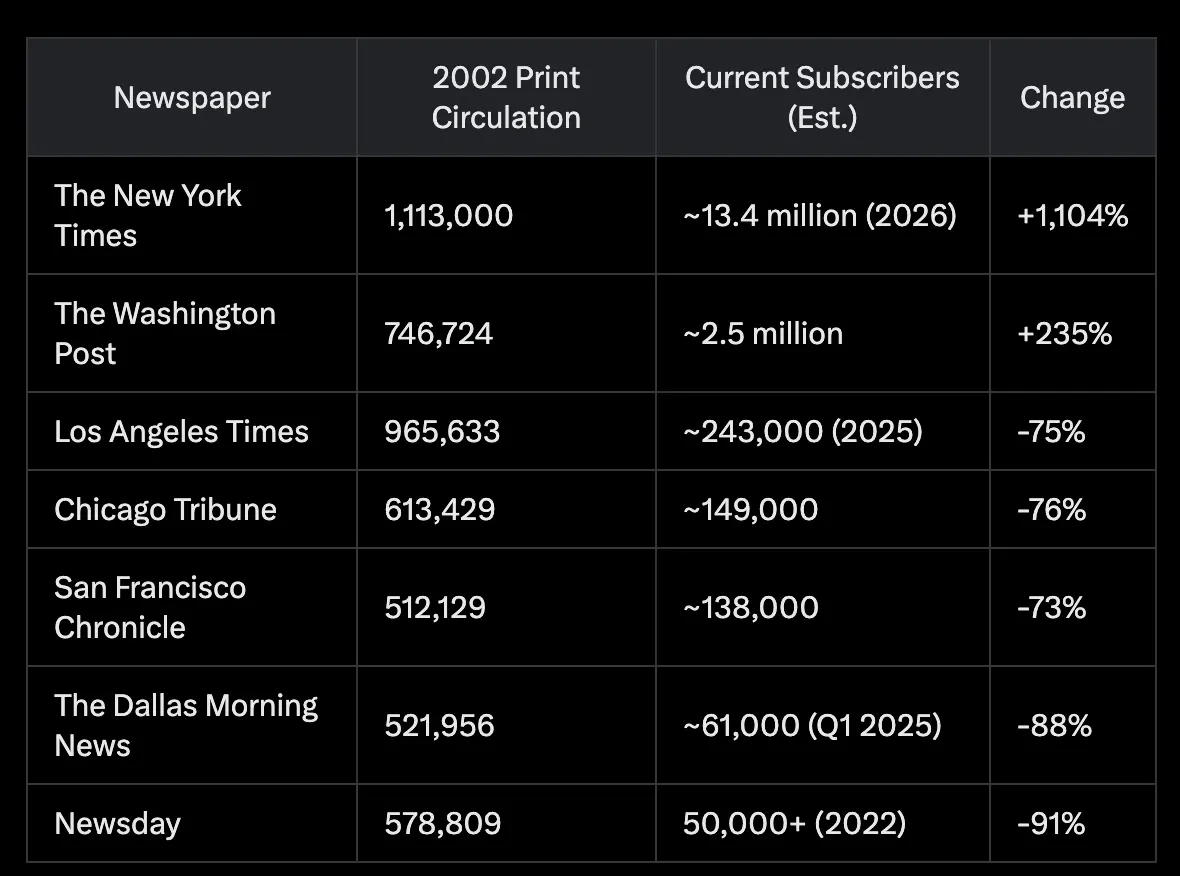
Vernal glaubt, dass KI eine ähnliche Struktur im Softwarebereich hervorrufen könnte.
Traditionelle Software-Moats stammen meist aus drei Faktoren:
Produktentwicklung ist teuer
Systemwechsel sind aufwendig
Integration schafft starke Ökosysteme.
KI schwächt alle drei: Konkurrenten können Funktionen schneller replizieren, Migration lässt sich stärker automatisieren, und KI vereinfacht Integration deutlich.
Mögliche Folge: ein Markt mit extrem starker Polarisierung:
Riesige Plattformen: Wenige Unternehmen könnten ganze Beschaffungskategorien dominieren – etwa Vertrieb, Marketing, Finanzen, Personalwesen, Recht oder Gesundheitswesen. Sie verkaufen nicht nur ein eng begrenztes Tool, sondern erweitern kontinuierlich, bis sie zum zentralen System für nahezu alle Kundenaktivitäten werden.
Mikro-Softwareunternehmen: Am anderen Ende könnten KI-Programmierwerkzeuge Millionen Menschen befähigen, hochspezifische Software für sich, ihr Unternehmen oder kleine Kundengruppen zu entwickeln. Einige davon könnten profitable Nischenunternehmen werden.
Eine unangenehme Mittelschicht: Mittelgroße Einzelpunkt-Lösungen stehen unter stärkstem Druck. Wenn große Plattformen deren Funktionen kontinuierlich übernehmen und kleine Teams schmale Produkte kostengünstig neu erstellen können, wird die Unabhängigkeit solcher Tools schwerer zu verteidigen.
Die Analogie zu Amazon verdeutlicht, wie neue Moats aussehen könnten: Amazon begann mit etwas Leichtem zu replizieren – dem Online-Buchverkauf. Seine Abwehrfähigkeit stammt aus jahrzehntelanger stetiger Reinvestition in Logistik, Infrastruktur, Technologie und Distribution.
KI könnte Softwarefirmen in dieselbe Richtung treiben: schneller bauen, kontinuierlich erweitern, wieder investieren – das Gesamtprodukt zunehmend schwerer replizierbar machen.
Für Risikokapital-finanzierte Software-Startups ergibt sich daraus eine strategische Frage: Wenn Softwarebau nahezu kostenlos ist – ist Ihre Moat noch das Produkt selbst oder vielmehr alles, was Sie rundherum aufbauen?
Wie wird Ihre Seed-Runden-Bewertung tatsächlich bestimmt? (Sie hängt fast gar nicht von Ihrem Unternehmen ab.)
Gründer gehen oft davon aus, dass die Bewertung vor allem von Wachstum, Marktvolumen oder der Überzeugungskraft ihres Pitches abhängt.
Doch es gibt eine weitere, meist kaum sichtbare Einschränkung: das ökonomische Modell des VC-Fonds Ihnen gegenüber.
Stellen Sie sich vor, Sie präsentieren sich einem Seed-Fonds mit 28 Mio. USD. Dieser investiert typischerweise etwa 600.000 USD und strebt einen Anteil von ca. 6 % bis 8 % an.
Bei 7 % Anteil ergibt eine Investition von 600.000 USD eine Post-Money-Bewertung von rund 8,6 Mio. USD; bei 6 % sind es 10 Mio. USD. Bei einer Finanzierung zu einer Bewertung von 18 Mio. USD könnte dieser Fonds daher möglicherweise sein Portfolio-Modell nicht einhalten.
Dies führt zu einer einfachen Kette:
Fondsvolumen → Investitionshöhe → Zielanteil → Machbare Höchstbewertung
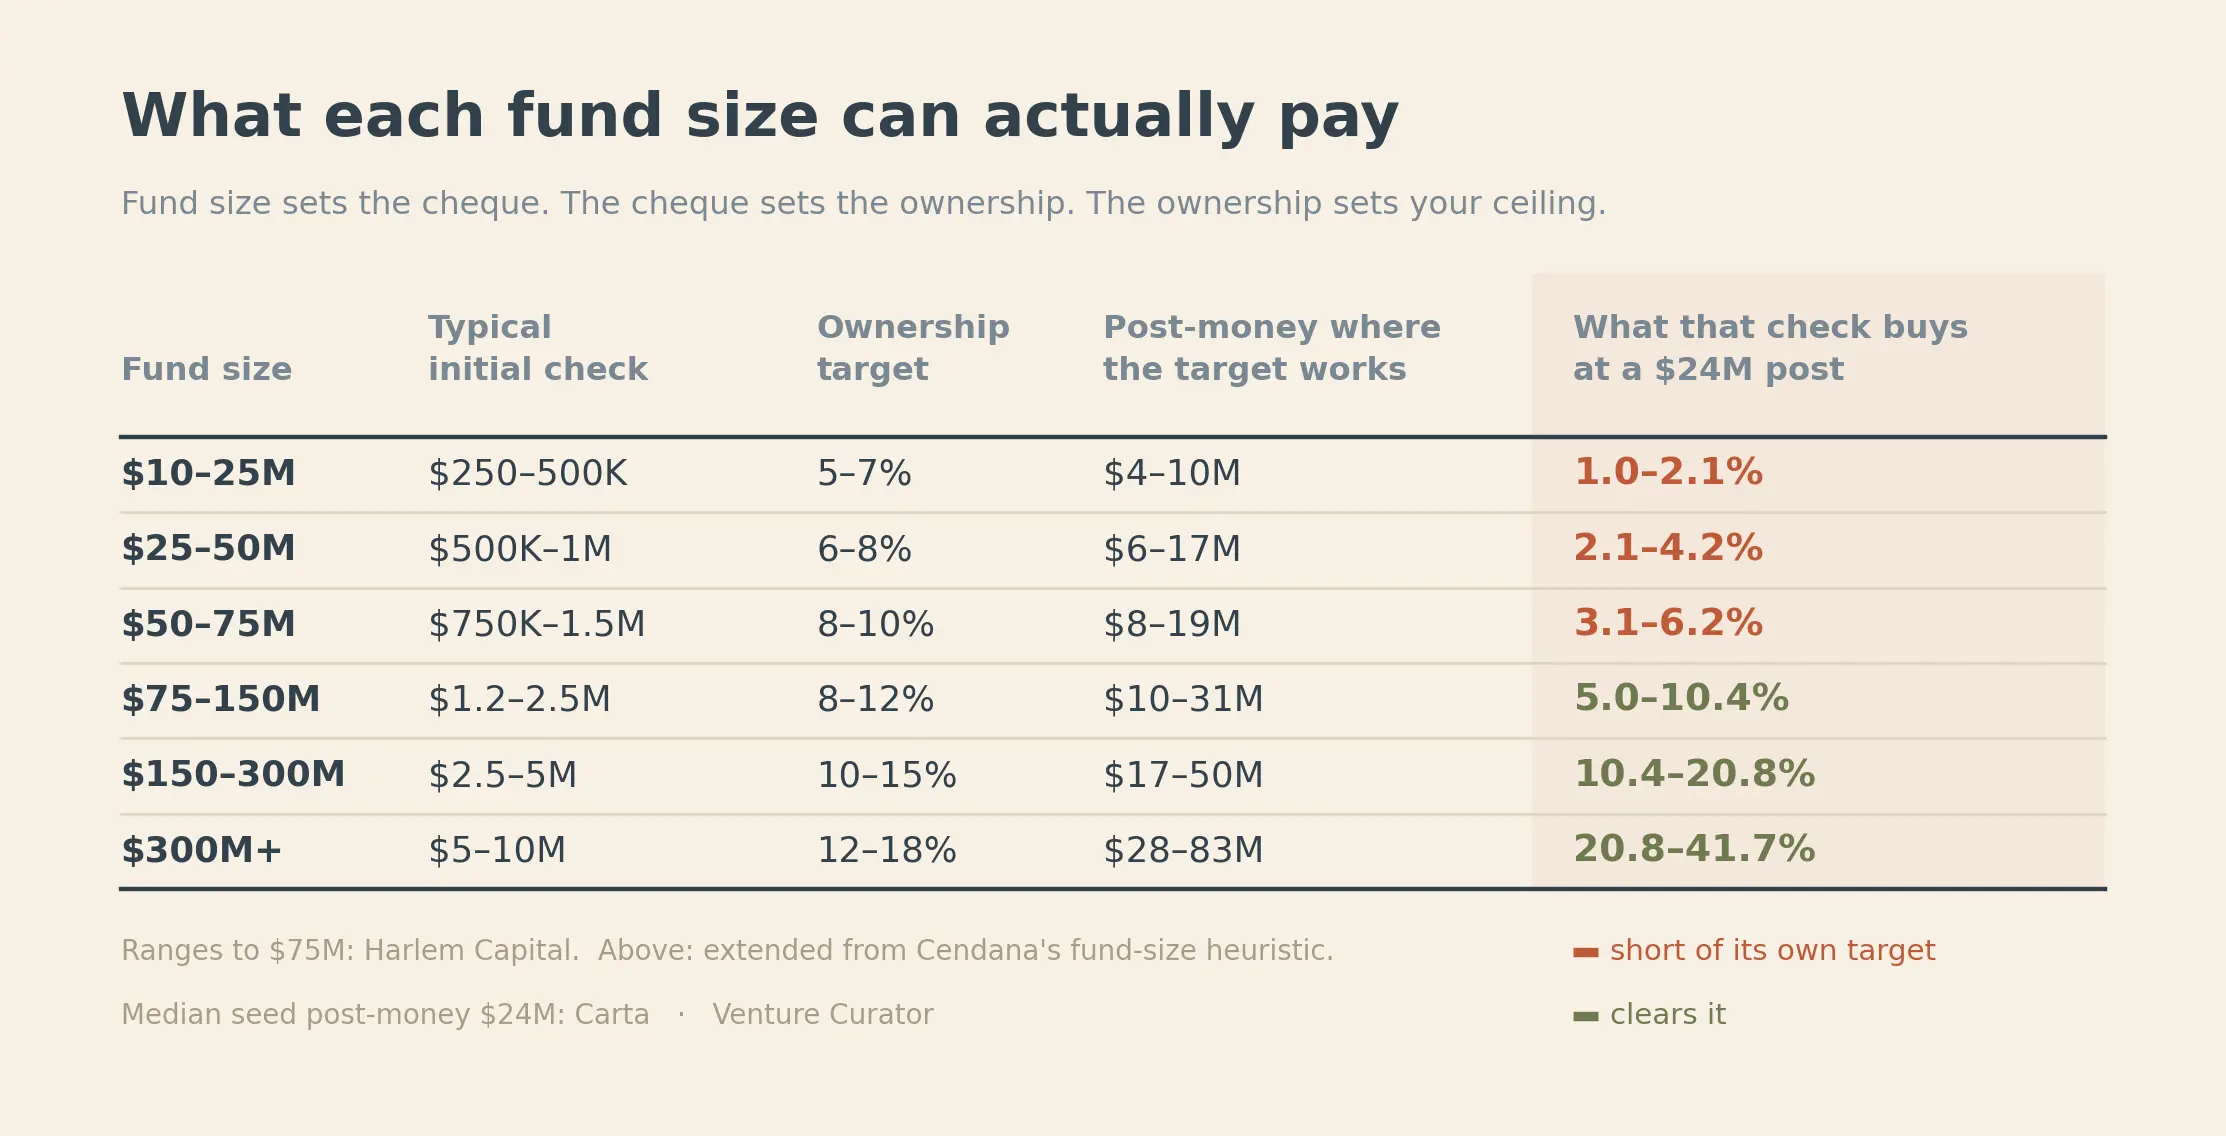
Dies ist heute wichtiger denn je, da die Seed-Runden-Bewertungen gestiegen sind. Der Median der Post-Money-Bewertungen für Seed-Runden laut Carta-Analyse liegt bei 24 Mio. USD. Ein 50-Mio.-USD-Fonds, der zu dieser Bewertung 1,5 Mio. USD investiert, erhält lediglich 6,2 % Anteil – womöglich unter seinem Zielwert.
Dies verändert auch, wie Gründer über Rundengrößen denken.
Wenn Sie einem Fonds mitteilen, dass Sie 3 Mio. USD aufnehmen möchten, und der Lead-Investor 15 % fordert, haben Sie implizit eine Post-Money-Bewertung von 20 Mio. USD festgelegt – noch bevor überhaupt explizit über die Bewertung gesprochen wurde.
Eine sinnvollere Vorgehensweise lautet:
Berechnen Sie, wie viel Kapital Sie benötigen, um den nächsten Meilenstein mit einer Laufzeit von 18 bis 24 Monaten zu erreichen.
Fügen Sie eine Reserve hinzu.
Das ist Ihre Rundengröße.
Teilen Sie diese durch den Dilutionsanteil, den Sie akzeptieren wollen.
Suchen Sie dann nach Fonds, deren Investitionshöhe und Beteiligungsmodell diese Bewertung unterstützen.
Ein weiterer oft übersehener Wert für Gründer ist der Optionspool. Der Lead-Investor kann verlangen, dass vor der Investition ein Optionspool von 10 % bis 15 % eingerichtet wird – was bestehende Aktionäre bereits vor Abschluss der Investition diluiert. Analysen zeigen, dass Verhandlungen zum Optionspool auf Basis konkreter Einstellungspläne manchmal stärker auf den Gründeranteil wirken als Debatten um zusätzliche 1 oder 2 Mio. USD bei der Schlagzeilen-Bewertung.
Um wertvolle Wochen mit falschen Fonds zu vermeiden, stellen Sie am besten in dem ersten Gespräch diese Frage:
„Wie hoch ist typischerweise die erste Investition dieses Fonds, und welchen Anteil streben Sie üblicherweise an?“
Diese beiden Zahlen ermöglichen Ihnen rasch eine Einschätzung, ob das ökonomische Modell des Fonds Ihre Finanzierungsrunde unterstützt.
Nehmen Sie daher nicht jede Bewertungskritik als Ablehnung Ihres Startups. Manchmal ist Ihr Unternehmen durchaus solide – nur passt Ihre Finanzierungsrunde nicht zur mathematischen Logik des Fonds.
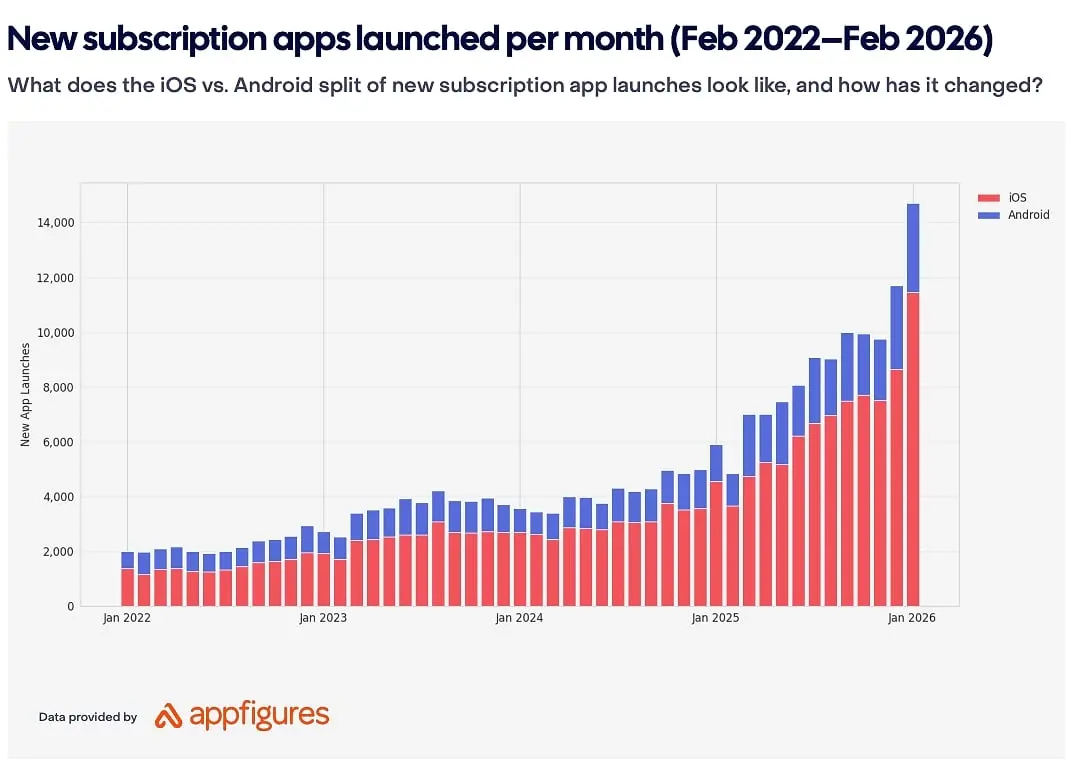
Wenn ChatGPT kostenlos das Gleiche leistet wie Ihre App, warum sollte jemand dafür bezahlen?
Dies wird zu einer der größten Herausforderungen für Gründer von Consumer-Apps.
Wenn Nutzer ChatGPT, Claude oder Gemini öffnen und in Sekunden ähnliche Ergebnisse erhalten, warum sollten sie dann monatlich 10 oder 20 US-Dollar für eine eigenständige App ausgeben?
Daphne Tideman von RevenueCat glaubt, die Antwort sei nicht einfach „mehr KI hinzufügen“. KI-gestützte Apps haben sich gut monetarisieren lassen: Jeder zahlende Nutzer erwirtschaftet 41 % mehr Umsatz als bei Nicht-KI-Apps und erreicht eine um 52 % höhere Trial-Konversionsrate. Doch ihre 12-Monats-Retention liegt nur bei 21,1 % – im Vergleich zu 30,7 % bei Nicht-KI-Apps.
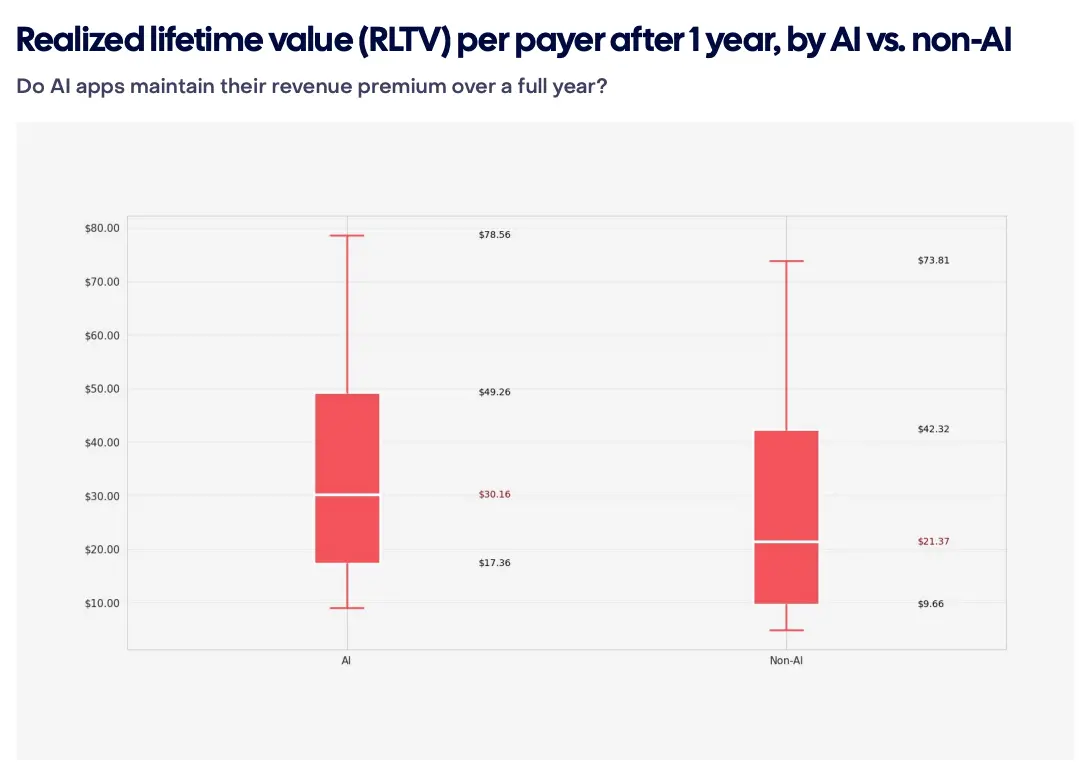
Mit anderen Worten: KI kann Nutzer anlocken – doch sie bietet möglicherweise keinen Grund, um zu bleiben.
Vergleichen Sie Chegg und Duolingo.
Der Unterschied liegt im Mehrwert jenseits der bloßen Antworten.
RevenueCat empfiehlt sechs Elemente, die mit einer leeren LLM-Chat-Oberfläche schwer zu replizieren sind:
Struktur: Aus einer Antwort einen kompletten Workflow oder Erlebnisraum machen.
Erinnerungsvermögen: Nutzer über Zeit verstehen – dadurch wird die App nützlicher.
Gewohnheitsbildung: Nutzer durch regelmäßige Check-ins, Erinnerungen, Begleitung und Gamification zurückholen.
Präzision: Spezialisiertes Wissen oder Daten beherrschen, um bessere Ergebnisse zu liefern.
Verbindung: Gemeinschaft, Identität, Persönlichkeit oder emotionale Bindung aufbauen.
Physisch-digitale Kombination: Software mit Sensoren, Geräten oder realweltlichen Daten verknüpfen.
Duolingo ist ein gutes Beispiel: Es vereint mehrere dieser Elemente. ChatGPT kann Sprachen unterrichten – doch Duolingo hat Jahre damit verbracht, kontinuierliche Check-ins, Bestenlisten, Fortschrittsysteme, Erinnerungen und Gamification aufzubauen. Nach Einführung der Bestenlisten stieg die Lernzeit um 17 %, stark engagierte Lerner vervielfachten sich dreifach.
Ein weiterer einfacher Test für Gründer ist der „leere Dialogfeld-Test“.
Öffnen Sie ChatGPT oder ein anderes LLM, beschreiben Sie präzise das Problem, das Ihre Nutzer mit Ihrer App lösen wollen, und vergleichen Sie die Antwort mit Ihrem Produkt. Wenn sich der Großteil Ihres Mehrwerts durch eine einzige Prompt-Antwort-Kombination replizieren lässt, besteht ein Differenzierungsproblem. Falls Ihre App jedoch Struktur, Datensammlung, Gewohnheitsbildung, Präzision, Verbindungen oder reale Komponenten integriert, liegt dort womöglich Ihre Schutzbarriere.
KI allein ist also möglicherweise keine Schutzbarriere. Die entscheidendere Frage für Gründer lautet: Was bietet Ihr Produkt Nutzern, das ein leeres Dialogfeld nicht kann? RevenueCat sieht die Gewinner darin, KI im Kern ihres Produkts einzusetzen – doch im Wettbewerb um die darauf aufbauenden Erlebnisse zu bestehen.